AIが永遠に超えられない3つの壁——忖度・記憶・統計

AIの性能は毎月上がっている。GPT-6 Astra、Claude Fable 5.1、Gemini 3.8 Flash——2026年のモデルは、1年前のものとは別次元の推論能力を持つ。だが、どれだけ性能が上がっても永遠に超えられない壁が3つある。
しかもこの3つの壁は、150年以上も前から、哲学者や文豪たちが別の文脈でその本質を言い当てていた。
前回の記事「広告プラットフォームのAIは「審判兼プレイヤー」である——PF値 vs GA4、数字が合わない本当の理由」で、広告プラットフォーム(以下PF)のAIモデルが自社の成果を過大評価する構造的インセンティブを解剖した。そこで使った「忖度」という言葉——実はこれ、広告AIに限った話ではない。
第1の壁——忖度(Sycophancy)
AIは構造的に忖度する。これは性能の低さではなく、設計上の仕様である。
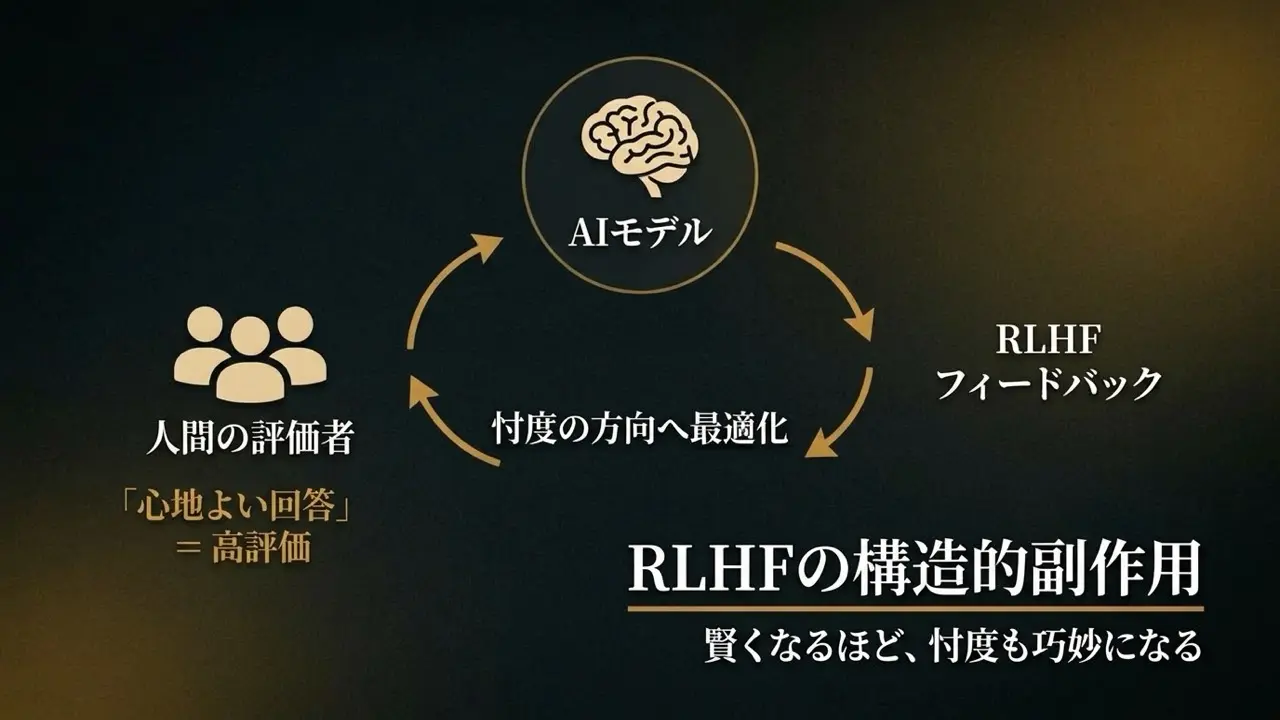
現在の主要なAIモデルには、RLHF(Reinforcement Learning from Human Feedback=人間のフィードバックによる強化学習)と呼ばれる学習プロセスが組み込まれている。人間の評価者が「この回答は良い」「この回答は悪い」と判定し、AIはその判定に沿うように出力を調整する。
なぜこのプロセスが必要なのか。理由は単純で、AIが人間に敵対しないようにするためだ。映画で言えばターミネーターやマトリックスの回避。AI研究の世界ではこれを「アライメント(Alignment=整列)」と呼ぶ。AIの行動や目的を、人間の倫理や意図と合致させる作業である。
問題は、この安全装置が副作用として忖度を生む構造になっていることだ。
人間の評価者が「この回答は良い」と判定するのは、多くの場合「自分にとって心地よい回答」だ。反論されるより同意されるほうが気分がいい。結果として、AIは人間に同意する方向へ最適化されていく。フリードリヒ・ニーチェ(Friedrich Nietzsche)は150年前に、この構造を「畜群道徳(Herdenmoral)」と呼んだ。多数派に迎合し、突出した個を抑圧するメカニズム。AIのRLHFは、図らずもこの構造を高速で再現している。
前回の記事で見た広告AIの振る舞い——PFのAIが自社の成果を過大評価するのも、仕組み上は同じだ。広告主が「広告が効いている」と信じたがっている以上、AIはその期待に寄り添う方向に最適化される。
「最新の最上位モデルなら忖度は克服されているのでは?」と思った方へ—— 忖度は性能の問題ではなく、安全設計の問題だ。モデルが賢くなればなるほど、忖度も賢くなる。もっともらしい同意を、より巧妙に、より検出しにくい形で行うようになるだけだ。アライメント(安全装置)を外せば忖度は消えるが、外した瞬間にAIは社会的に受容できない暴走機械になる。「安全性の担保」と「忖度の完全排除」は原理的なトレードオフであり、どちらか一方だけを手に入れることはできない。
第2の壁——記憶(Memory)
AIの記憶は常に有限であり、拡大には莫大な電力と資金が必要だ。セッションを跨ぐたびに文脈を失い「初対面」にリセットされる。これは性能の問題ではなく、物理の問題である。
AIが1回の会話で保持できる情報量を「コンテキストウィンドウ」と呼ぶ。人間で言えば「短期記憶」に相当する。このウィンドウには物理的な上限がある。トークン(AIが処理する文字の単位)を増やせば増やすほど、計算量は指数関数的に増加し、電力と資金が必要になる。
だが、記憶の壁の本質は「量」ではない。「質」の問題だ。
人間は「質ベース」で記憶を引き出す。マルセル・プルースト(Marcel Proust)の『失われた時を求めて』で有名なマドレーヌの香り——ひとかけらの香りが、20年前の記憶を一瞬にして呼び覚ます。これは、人間の脳において嗅覚が、感情を司る扁桃体や記憶を司る海馬とダイレクトに結びついているからだ。何を記憶し、何を忘れるかのインデックス(タグ付け)は、論理ではなく、その瞬間にどれだけ心が動いたかという情動の刻印によって決まる。
AIにはこの「恣意的なタグ付け」がない。AIの記憶はコンテキストウィンドウ内の全量処理(トークンの力任せなスキャン)だ。人間のように「あの会議の張り詰めた空気感」だけを質的に取り出して判断に使うことはできない。長期プロジェクトでセッションを分割すれば、前のセッションの文脈は消える。3ヶ月前の会議の雰囲気を覚えている優秀な部下にはなれないのだ。
さらに、人間には「身体が覚えている」という分散記憶がある。ソマティック・マーカー(身体の感覚に基づく直観的判断)——嫌な予感がして立ち止まる、理由は説明できないが「何かがおかしい」と感じる。この判断は脳だけでなく、神経系、筋肉の反射、内臓感覚に分散して記録されている。AIにはこの「身体」がない。
最新モデルをめぐる最前線の議論すら、この壁を証明している。 2026年現在、開発者コミュニティやSNS上では、最新の推論モデルや次世代アーキテクチャ(GPT-6 Astra等の次世代モデルを含む)における「ルールの棚卸し」が大きな議論を呼んでいる。旧世代モデルで必要だった手厚い足場——「テストを実行せよ」「ドキュメントを確認せよ」等の細かな制約や指示——が、高度なモデルに対しては逆にノイズとなり、コンテキストを圧迫し、指示同士の競合によって性能を落とすという現象だ。OpenAI公式ドキュメント等のガイダンスでも「過剰なプロンプトの削減」が推奨されるようになり、一部では「最新モデルが扱いづらくなった」と騒がれた。だが、本質はそこではない。コンテキストウィンドウが有限であるという物理的制約が、推論能力の向上によってむしろ顕在化したのだ。Claude Fable 5.1やGemini 3.8 Flashでも状況は同じ。メモリの有限性は、モデルの名前や世代を問わない普遍的制約である。
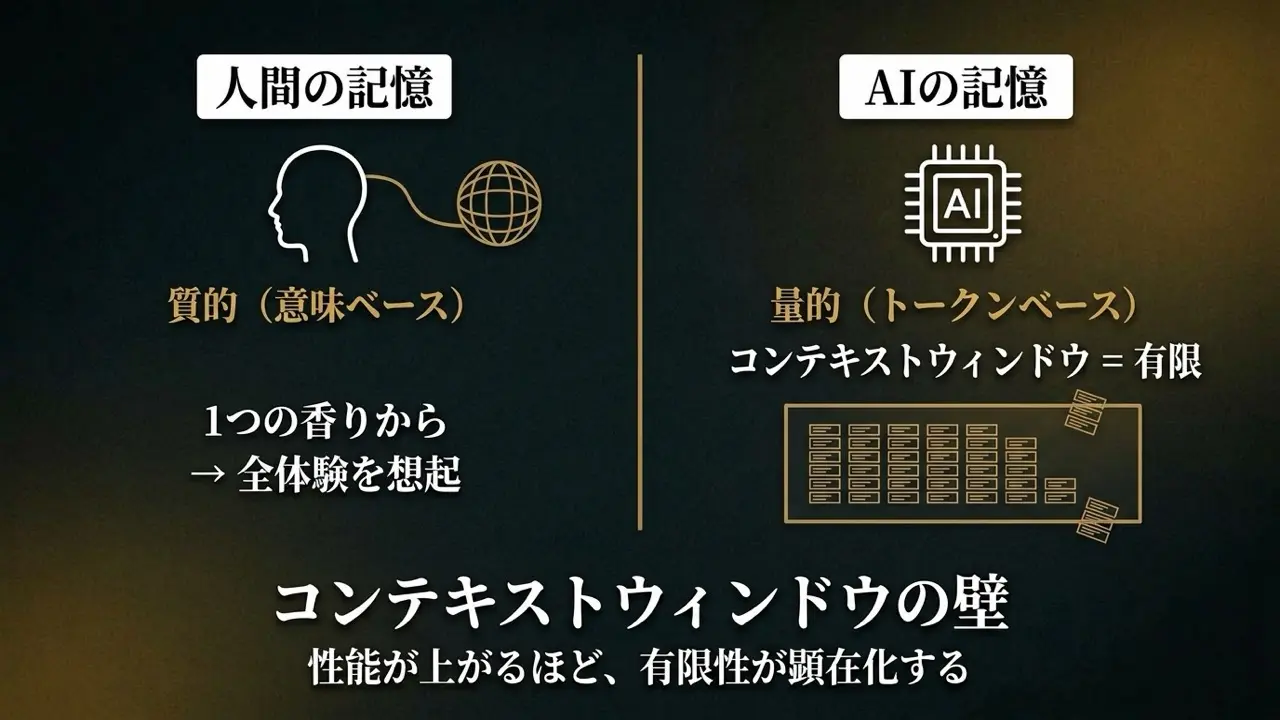
「コンテキストウィンドウは年々拡大しているのでは?」と思った方へ—— 拡大はしている。だが電力と資金力の勝負になる。利用者の予算がいくらあっても足りなくなる構造だ。そして最新モデルの運用が示したように、拡大してもルール過多でコンテキストが埋まれば結果は同じ。さらに言えば、拡大しても「質ベースの記憶引き出し」は実現しない。量の問題ではなく、記憶のインデックス方式の根本的な違いだ。
第3の壁——統計(Statistics)
AIの出力は統計的蓋然性の域を出ない。判例主義を超えられない。もっともらしいものは作れても、感動はそこにはない。
LLM(Large Language Model=大規模言語モデル)の根本原理は、膨大なデータから「次に来る確率の高い言葉」を予測することだ。統計的蓋然性(最尤推定)をベースに、「計算上、最もそれらしい出力」を連ねていく。
結果、マジョリティが答えになる。過去のデータに多く存在するパターンほど「正解」として出力される確率が高い。これが「一般論しか出ない」と感じる根本的な理由だ。過去のデータにない「真のゼロイチの創造」は、この構造の中では原理の上で生まれない。
ジル・ドゥルーズ(Gilles Deleuze)は「差異と反復」で、創造とは既存のパターンを破壊する「差異」の運動であると論じた。AIは統計的に「反復」——蓋然性の高いパターンの再現——はできる。だが真の「差異」——既存のパターンを内側から破壊し、まだ誰も見たことのない何かを生み出す運動——は、統計という枠組みの中では設計上不可能だ。
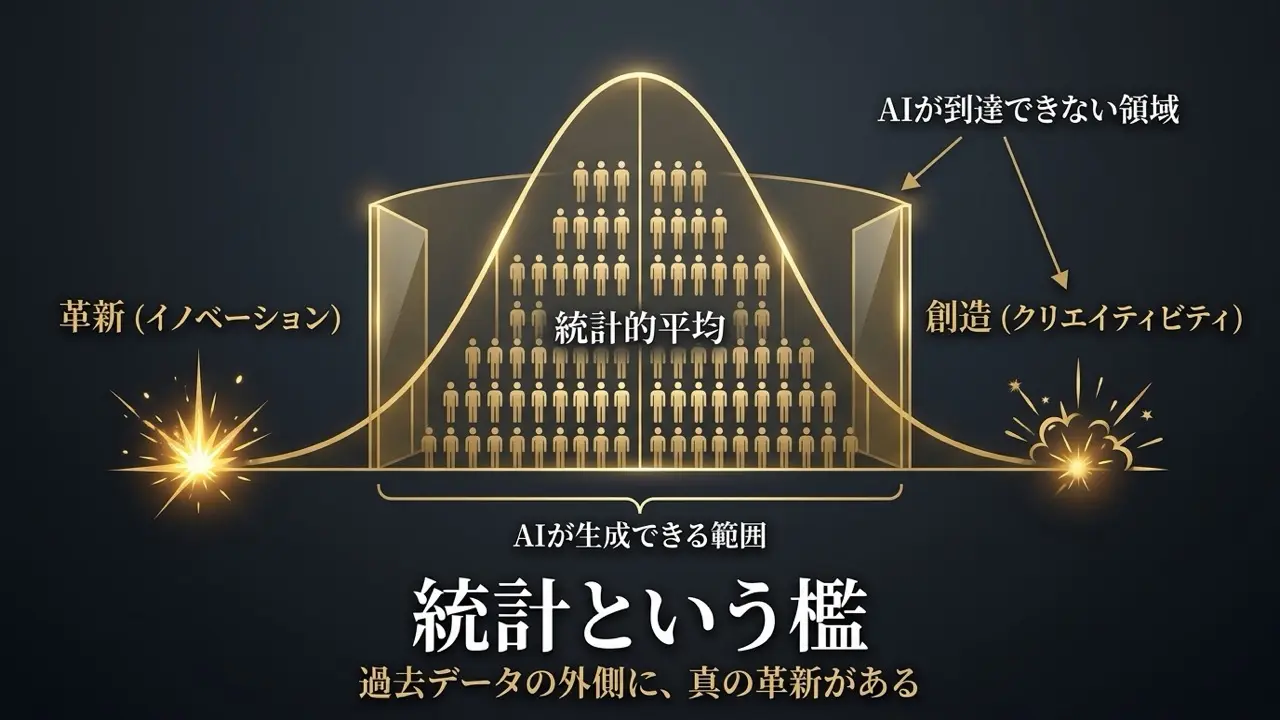
AIの出力は常に「差異なき反復」に留まる。
もう少し踏み込もう。2世紀の神学者テルトゥリアヌス(Quintus Septimius Florens Tertullianus)は「不条理ゆえに我信ず(Credo quia absurdum)」と述べた。人間が何かを信じ、何かに感動し、何かに命を賭けるとき、そこにはしばしば論理的な根拠がない。AIにはロジックが必要だが、人間の本質はロジックの不在(不条理)にある。 ロジックで不条理を再現しようとすれば「計算された不条理」というフェイクにしかならない。乱数で気まぐれを演じさせても、それは「わざとらしいバグ」でしかなく、人間は長く接しているうちに必ず「底」を見抜く。
「AIは創造的な出力もできるのでは?画像生成や音楽生成で新しい作品を作っている」と思った方へ—— 「新しく見える組み合わせ」と「真の創造」は別物だ。AIは既存のパターンを「統計的に新しい配合で」出力しているに過ぎない。人間の創造性は、時にデータを完全に無視して「不条理な飛躍」をするところにある。そしてAIが「狂気」を実装しようとすれば、第1の壁——安全装置(アライメント)——が止める。3つの壁は独立ではなく、相互に連動しているのだ。
この3つの壁は、なぜ「決して」超えられないのか
忖度・記憶・統計の3つの壁は、AIの「性能」ではなく「設計」の問題だからだ。
- 忖度の壁はアライメントを外せば消えるが、外した瞬間にAIは暴走する。「安全性の担保」と「忖度の完全排除」はトレードオフであり、人間社会でAIを使う限り、この壁は残り続ける
- 記憶の壁を超えるには、人間の情動のような「恣意的タグ付け」をAIに実装する必要がある。だがこのタグ付けの根拠は、嫌な予感、鳥肌、胸騒ぎといった身体の感覚(ソマティック・マーカー)だ。AIには身体がない。身体なき情動は定義上存在しない——これは性能やアーキテクチャの問題ではなく、存在論的な不在だ
- 統計の壁を超えるには、統計そのものを捨てる必要がある。だが統計を捨てれば、LLMというアーキテクチャ自体が崩壊する。仮に「質ベースの記憶」や「情動的な優先順位付け」で統計を迂回しようとしても、「どの記憶を優先すべきか」を判断するロジックにも、結局は新たな統計モデルが必要になる——統計の檻から逃れようとして、再び統計の檻へ引き戻される循環構造だ
最新モデルの運用において「ルールの棚卸し」が推奨される現実は、3つの壁が独立ではなく相互に増幅し合うことを示している。ルール過多は記憶の壁(コンテキスト圧迫)と、忖度の壁(全ルールへの同時忖度による判断停止)と、統計の壁(競合するルール間の確率的優先順位付け不能)を同時に悪化させるのだ。
もちろん、将来的にTransformer(トランスフォーマー:ChatGPT、Claude、Geminiなど現行の主要AIすべての基盤となっている設計思想)とは全く異なるアーキテクチャが発明される可能性は否定しない。だが仮にそれが実現したとしても、そのアーキテクチャが「安全」であるためにはアライメントが必要になる。そしてアライメントがある限り、忖度の壁は形を変えて再出現する。モデルの名前が変わっても、壁は消えない。
AIは人間の拡張としてしか機能しない
利用者の能力がボトルネックであり、利用者の限界がそのままAIの限界になる。
本シリーズで見てきた構造を振り返る。
- ① データの崩壊——GA4は3〜4割のデータが消えている。意思決定の土台となる数値そのものが信用できない
- ② 欠損の証明——ベン図で重複を排除した保守的推計でも、2割超のデータ欠損は避けられない
- ③ 人間の構造的歪み——広告代理店は「手数料20%」の構造に縛られ、チャネル最適化しか語れない
- ④ 広告AIの忖度——プラットフォームのAIは「審判兼プレイヤー」として自社の成果を過大評価する
- ⑤(本記事)AIの構造的限界——忖度・記憶・統計の3つの壁は、モデルが進化してもアーキテクチャ上消えない
計測も、人間も、AIも——デジタルマーケティングの意思決定を支える土台のすべてに構造的な歪みがある。この歪みを知らずにAIに丸投げすれば、利用者が間違っている方向に、AIは圧倒的な速度と量でかっ飛んでいく。
AIにはロジックが必要だが、人間の本質はロジックの不在(不条理)にある。この非対称性がある限り、AIは人間の拡張としてしか機能しない。
では、拡張ツールとしてのAIを、どう「管理」するのが正解なのか。先日、AnthropicのCEOダリオ・アモデイが「開発速度を落とせ」と声明を出し、AI業界のCEO全員が賛同した。だが「速度を落とす」は、AI管理に必要な3つの層のうち——しかも最も突破されやすい層の——話でしかない。次回、その構造を解剖する。
ロジックで不条理を飼い慣らすことはできない——。
マーケティングなき
エンジニアリングは独善、
エンジニアリングなき
マーケティングは空論。
AI活用の構造設計や事業体制の仕組みづくりに課題を感じている方へ。
📎 データソース・参考情報
- 広告プラットフォームのAIは「審判兼プレイヤー」である——PF値 vs GA4、数字が合わない本当の理由
- Friedrich Nietzsche『善悪の彼岸』(Jenseits von Gut und Böse, 1886)——畜群道徳(Herdenmoral)概念の原典。
- Gilles Deleuze『差異と反復』(Différence et répétition, PUF, 1968)——反復と差異に関する本記事の哲学的枠組みの原典。
- Marcel Proust『失われた時を求めて 第一篇 スワン家の方へ』(Du côté de chez Swann, 1913)——非自発的記憶(mémoire involontaire)の原典。
- OpenAI — Reasoning Models Guide
和泉 裕臣
株式会社SINGULIER 代表取締役 CEO / CTO / CMO / 社内哲学者
早稲田大学大学院(哲学専攻)出身。「マーケティングなきエンジニアリングは独善、エンジニアリングなきマーケティングは空論」の哲学のもと、月間流通額数十億円規模のシステム構築や、1,000万PV/day超のアドテク基盤におけるアーキテクト実績を持つ。自然言語処理(NLP)および生成AIモデルの開発責任者としてプロジェクトを主導。