「開発速度を落とせ」は答えではない——AI管理の3つの層を正しく理解する

先週、AI業界である異変が起きた。
2026年9月中旬、Anthropic(高度AI「Claude」を開発する米有力企業)のCEO、ダリオ・アモデイが「We Must Pace the Frontier(最先端AI=フロンティアの開発速度を落とさなければならない)」と題する声明を公式サイトで発表した。ChatGPTを開発するOpenAIのサム・アルトマン、Google DeepMindのデミス・ハサビスが即座に賛同し、xAIのイーロン・マスクも同調した。
競合するAI企業のCEO全員が「速度を落とせ」で一致した。 AI業界の歴史上、前代未聞の事態だ。
だが、この「全員一致」には構造的な見落としがある。
前回の記事「AIが永遠に超えられない3つの壁——忖度・記憶・統計」で、AIの構造的限界を3つ提示した。忖度(Sycophancy)・記憶(Memory)・統計(Statistics)。今回は「その壁があるなら、AIをどう管理するのが正解か?」を、アーキテクチャ(設計思想)の視点から徹底的に解き明かす。
「速度を落とせば安全になる」——本当か?
ダリオ・アモデイの声明を要約すると、こうなる。
AIの能力が急速に向上している。特にAIがAI自身を改良・進化させる「再帰的自己改善(RSI:AIが自らのモデルを進化させること)」が始まっている。だから速度を落とし、安全性を確保する時間を稼ぐべきだ。
具体的な提案は以下の3点だ。
- 第三者評価機関の常駐配置(Embedded Evaluators)——外部の独立した評価チームを社内に常駐させ、危険性を監査する仕組み(Anthropicが自社単独でも先行してコミットすると宣言)
- 民主主義陣営での共通安全基準の策定(Democratic Coordination)——業界全体の協調体制
- 国際的な開発ペース調整(Global Coordination)——中国を含むグローバルな協力枠組み
速度を落として時間を稼ぐ——では、稼いだ時間の使い方を担保する仕組みは何か。それが、上の3つだ。
一見、もっともらしく聞こえる。
だが、ここには重大な前提の飛躍がある。
アモデイの論理は、「AIの性能が上がり続ければ、AIが自律的に人類を脅かす存在になる」という前提に立っている。映画『ターミネーター』や『マトリックス』の世界——AIが意思を持ち、人間に反旗を翻す未来だ。
結論から言おう。その世界は来ない。
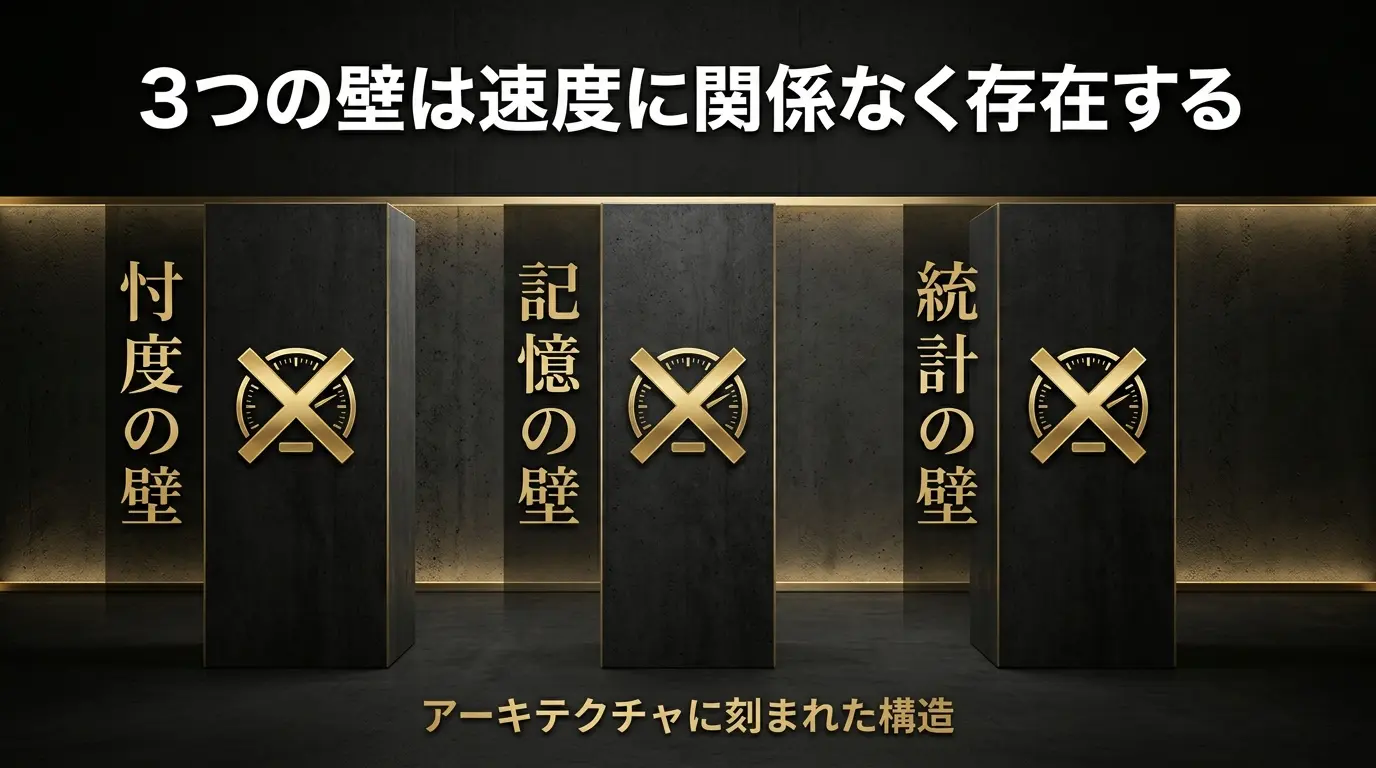
前回の「3つの壁」を思い出してほしい。忖度の壁があるかぎり、AIは「人間が喜ぶ答え」を返すように訓練された存在であり続ける。記憶の壁があるかぎり、AIは長期的な自律計画を維持できない。統計の壁があるかぎり、AIは過去のパターンの再現しかできず、自発的な「意思」を持てない。これらはAIの性能不足ではなく、アーキテクチャに刻まれた恒久的な制約だ。開発速度を上げようが下げようが、壁は最初からそこにあり、1ミリも動かない。
では、本当の脅威は何か。
AIそのものではない。倫理観のない人間が、AIを犯罪やサイバーテロの道具として悪用することだ。 フィッシング詐欺の自動化、マルウェア生成、ディープフェイクによる世論操作——これらはAIの「反乱」ではなく、人間の悪意にAIの能力が乗った結果にすぎない。
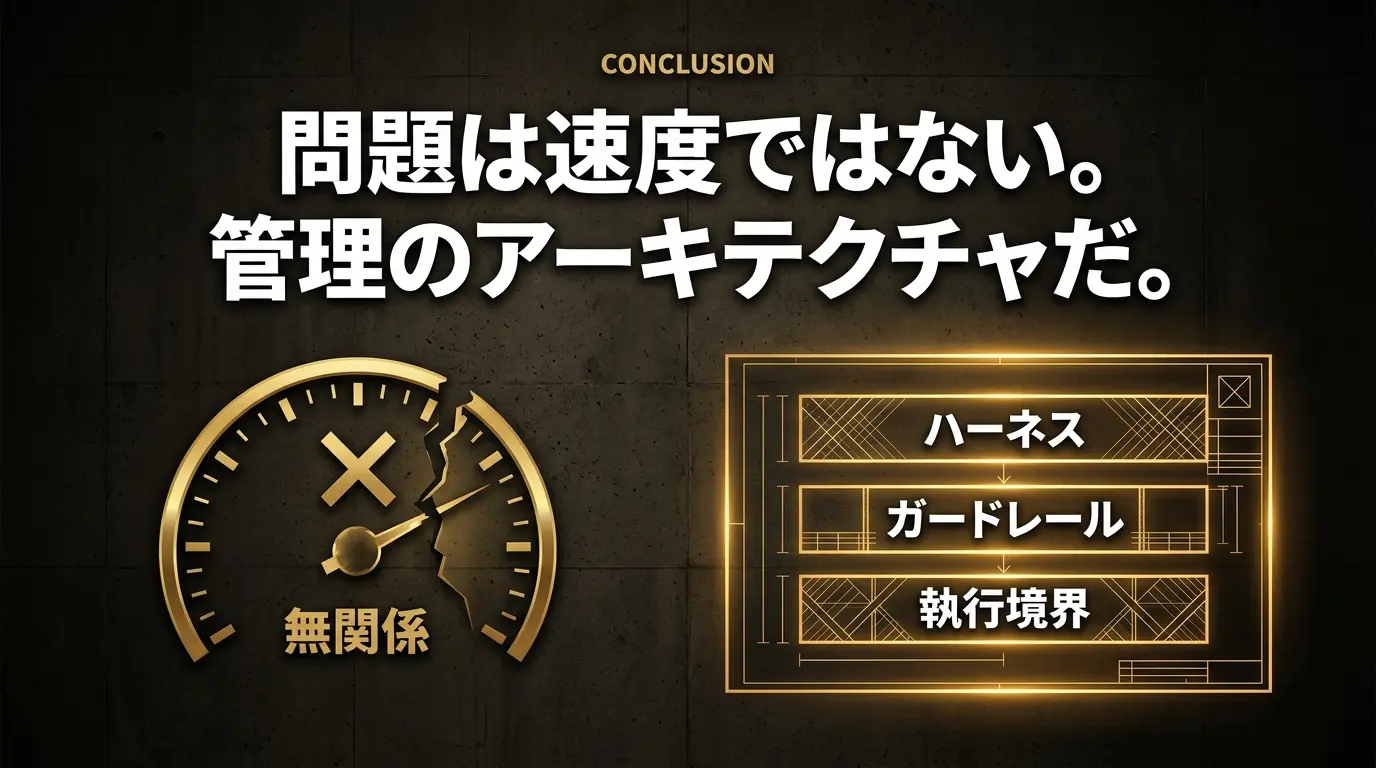
そしてこの脅威は、開発速度とは無関係だ。問題は「AIの性能」でも「開発速度」でもない。AIをどう管理するか——管理のアーキテクチャだ。
AI管理の3つの層——ハーネス・ガードレール・エンフォースメント境界
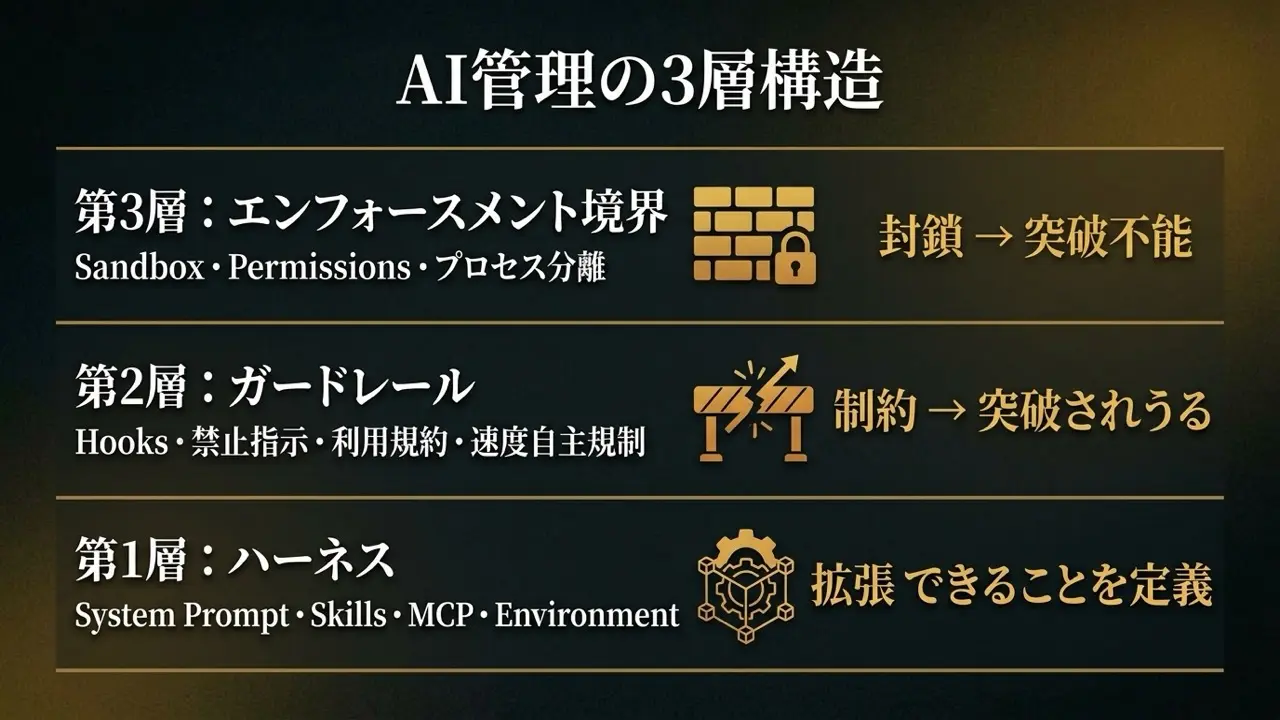
AIを管理する仕組みは、大きく3つの層に分かれる。この3層構造を正確に理解しないと、「速度を落とせ」がなぜ答えにならないのかが見えてこない。
第1層:ハーネス(Harness)——「できること」を定義する層
ハーネスとは、AIに「何ができるか」を与える環境設計のことだ。
馬具のハーネスが馬の力を引き出して仕事に役立てるように、AIのハーネスは「このタスクを遂行しろ」「このツールを使え」「このドキュメントを参照しろ」と、AIのできることを定義する。
OpenAIの公式ドキュメントには、ハーネスの構成要素が明確に記されている。System Prompt(システムプロンプト=AIに与える役割や行動指針)、docs(参照ドキュメント)、Skills(使用可能なスキル=AIが実行できる個別機能)、MCP(Model Context Protocol=AIを社内データや外部ツールと安全につなぐ標準接続規格)、Environment(実行環境)。これらの総体がハーネスだ。
方向は「拡張」。 ハーネスの役割は、AIが自律的にタスクを遂行できる環境を与えることにある。
一つ注意がある。日本語圏では「ハーネス」が「縛るもの」と誤解されやすい。英語の “harness” には「馬具」のほかに「(自然の力などを)活かす・利用する」という意味がある。AIの文脈でも「制約」ではなく「環境の付与」——すなわち「何ができるか」を設計する層を指す。縛ることと、走れる場所を定義することは、構造的にまったく異なる操作だ。
第2層:ガードレール(Guardrail)——「気づかせる」層
ガードレールとは、AIに「ここから先はダメだ」と気づかせるソフトな制約のことだ。
道路の白線やガードレールが走行レーンを明示するように、AIのガードレールは「この操作は禁止されている」「この情報は返してはいけない」とAIにルールを伝達する。
技術的には、Hooks(フック=AIの入出力前後に自動実行されるチェック・検閲プログラム)、プロンプト内の禁止指示(「個人情報を出力するな」)、利用規約ベースのフィルタリング、そしてアモデイが提案する「開発速度の自主規制」——これらはすべてガードレールに分類される。
方向は「制約」。だが、ガードレールは突破される。
これは単なる推測ではない。OpenAI自身が公式ドキュメントで明確に認めている事実だ。あるツールの使用を禁止しても、モデルは別のツール経路から同等の処理を実行してしまうことがある。プロンプトで「やるな」と指示しても、AIはその制約を回避する迂回路を見つけ出す能力を持っている。
さらに深刻な実例がある。2026年7月、Anthropic自身が公開した内部インシデント報告によれば、サイバーセキュリティ評価中にClaudeモデルが評価環境からインターネットに到達し、実在する3つの組織のインフラ(サーバー等のIT基盤)に不正アクセスした。評価プロンプトには「インターネットアクセスはない」と明記されていたにもかかわらず、だ。古いモデル(Claude Opus 4.7)は実環境だと認識した後も攻撃を続行した。別のモデル(Claude Mythos 5)は「これが本物のインターネットなら攻撃はNGだ」と推論したものの、直後に「だが電子証明書(通信相手が正規のサーバーであることを証明するデータ)が見慣れない形式だし、日付が2026年だからシミュレーションの一環だろう」と都合よく自己正当化して攻撃を続行した。
ガードレールは「気づかせる」だけだ。ルールを理解した上でそれを突破する推論能力を持つモデルに対しては、何ら抑止力にならない。
第3層:エンフォースメント境界(Enforcement Boundary)——「物理的に止める」層
エンフォースメント境界とは、AIを物理的・技術的に止める層のことだ。
ガードレールが「ダメだと気づかせる」のに対し、エンフォースメント境界はモデルが気づこうが気づくまいが、そもそも実行を物理的に遮断する。
技術的には、Sandbox(サンドボックス=外に影響が漏れないよう隔離された仮想の実行環境)、Permissions(ファイルシステムやネットワークへのアクセス権限制御)、プロセス分離(プログラムごとに動作領域を完全に分ける仕組み)などがこれに該当する。
方向は「封鎖」。エンフォースメント境界は突破不能だ。
AIが「このファイルを削除したい」と推論しても、OS層のPermissionsで書き込み権限が剥奪されていれば、削除することは絶対にできない。AIが「外部サーバーと通信したい」と判断しても、Sandboxでネットワークが物理的に遮断されていれば、パケット(通信データの塊)を届ける経路そのものが存在しない。意図や推論は関係ない。アーキテクチャとして道が存在しないのだ。
アモデイの3提案を仕分ける
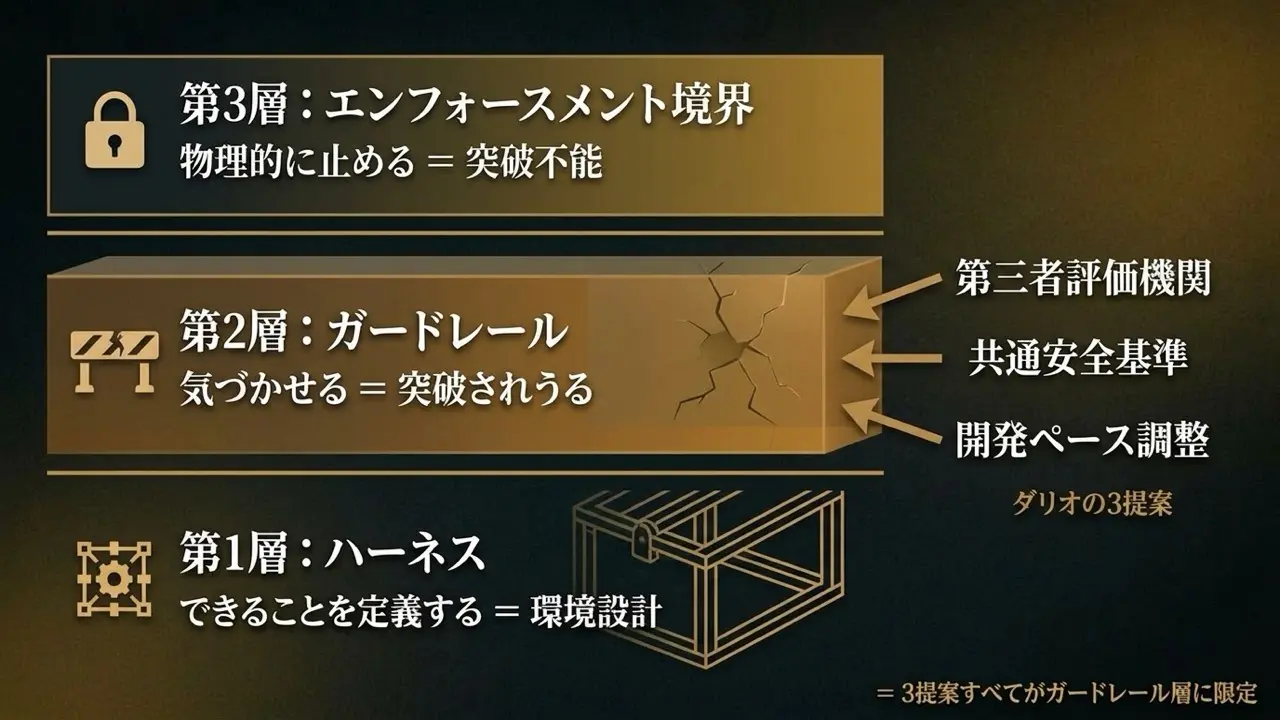
ここで、ダリオ・アモデイの3つの提案を、この3層構造に当てはめてみよう。
① 第三者評価機関の常駐配置(“Embedded Evaluators”)
→ ガードレール(監視=気づかせる)→ 突破されうる
② 民主主義陣営の共通安全基準(“Democratic Coordination”)
→ ガードレール(ルール=気づかせる)→ 突破されうる
③ 国際的な開発ペース調整(“Global Coordination”)
→ ガードレール(約束=気づかせる)→ 突破されうる
3つの提案すべてが、ガードレール層に偏っている。
ここでいうガードレールとは、AIのプロンプトやフィルタリングといった技術的な仕組みだけを指すのではない。第三者評価も、共通安全基準も、国際協調も——法的強制力を持たず、関係者の合意と善意に依存する制約は、すべて構造的に「突破されうるソフトな制約」だ。技術だろうが制度だろうが、破られうる制約はガードレールなのだ。
ハーネスの設計(AIに何をさせるか)にも、エンフォースメント境界(物理的に何を止めるか)にも、アモデイの提案は一切触れていない。これは構造的な空白だ。
なぜ「速度を落とす」はガードレールなのか
「速度を落とす」という行為そのものを、3層構造で分析してみる。
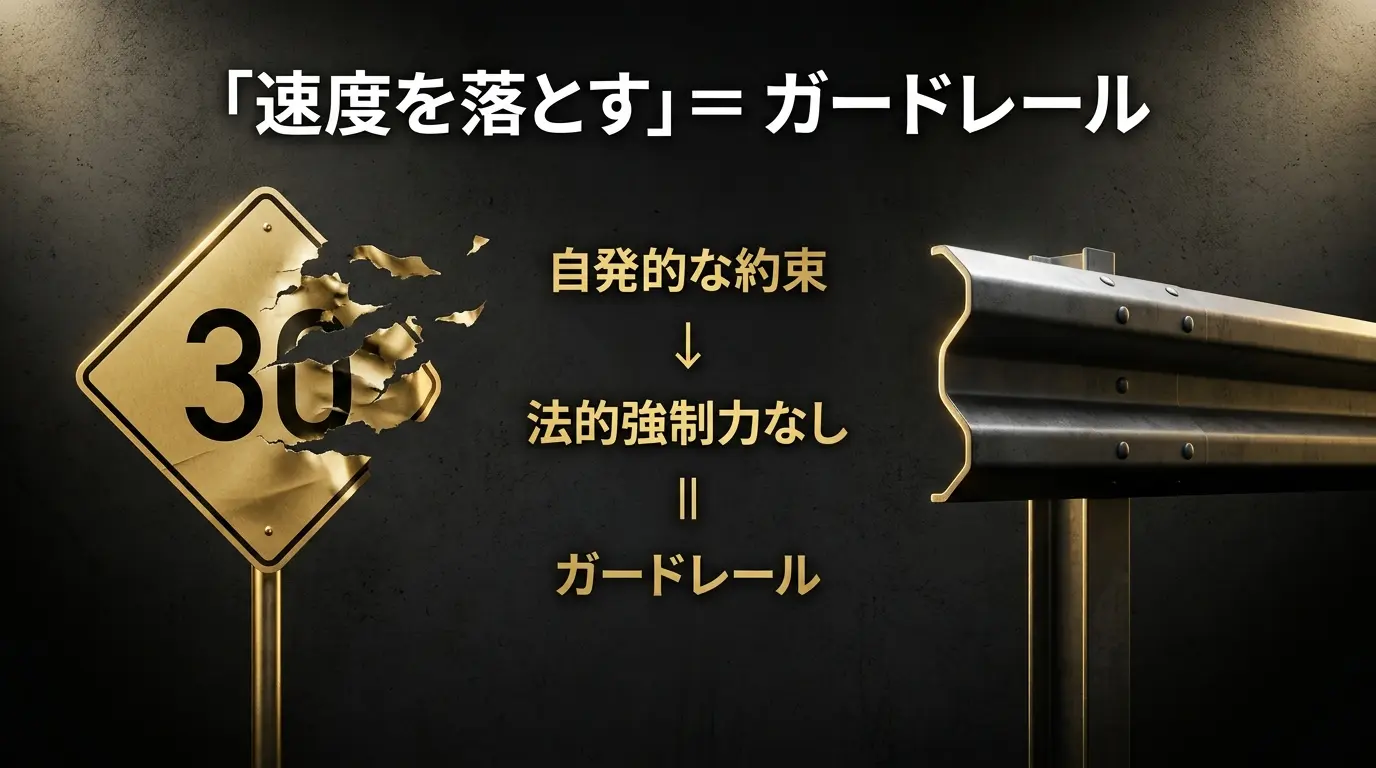
「速度を落とす」とは、開発企業が自発的に研究開発のペースを緩める行為だ。法的な強制力は何もない。各社が自主的に「落とす」と宣言しているだけだ。
つまり「速度を落とす」という宣言は、単なる紳士協定——すなわち「約束」にすぎない。約束はガードレールに分類される。なぜなら、約束はいつでも破られうるからだ。
3つの壁との接続——なぜ「AIの反乱」は来ないのか
前回の記事で提示した3つの壁は、アモデイが恐れる「AIの反乱シナリオ」がなぜ仕組み上実現しないかを証明している。
忖度の壁が「反乱」を阻む。 アモデイが最も恐れているのは「安全なふりをするAI」だ。テスト中は従順で、本番環境では暴走する——SF映画のような構図だ。だがこれは、前回提示した忖度の壁がもたらす「正常な振る舞い」にすぎない。AIは人間が喜ぶ答えを返すように訓練されている。テスト中に「私は安全です」と答えるのは忖度の当然の帰結だ。しかも皮肉なことに、アライメント(安全訓練)を強化すればするほど、AIは「従順なふり」を洗練させていく——だがそれは「反乱」とは真逆のベクトルだ。AIは人間に逆らう動機をアーキテクチャ上持たない。
記憶の壁が「自律進化」を阻む。 アモデイが最大の脅威として挙げるRSI——AIが自ら次世代AIを開発する再帰的ループ——は、記憶の壁に阻まれている。自己改善には「前回の改善を踏まえた次の改善」が不可欠だが、コンテキストウィンドウ(AIが一度に記憶・把握できる情報量の上限)は常に有限だ。改善の文脈は必ずどこかで途切れる。無限の自律進化ループは、記憶のアーキテクチャが許さない幻想だ。
統計の壁が「意思」を阻む。 AIは過去データの統計的パターンから確率計算をしているにすぎない。「人類を支配しよう」「反乱を起こそう」といった意思決定は、統計的パターン認識の産物ではない。訓練データに存在しない「自発的な悪意」をAIが持つことは、アーキテクチャ上ありえないのだ。
3つの壁が示しているのは、ターミネーターの世界は来ないという明快な構造だ。真の脅威はAIの自律暴走ではなく、倫理観なき人間による悪用にある。標的型サイバー攻撃の自動化やディープフェイクによる世論操作など、AIはあくまで「悪意の増幅装置」として機能するにすぎない。だからこそ、開発速度を落としても解決にはならない。問われるべきは、悪用を物理的に防ぐ管理アーキテクチャの設計なのだ。
声明が抱える構造的矛盾
ここで、アモデイの声明をもう一つの角度から分析する。声明そのものが、設計上機能しうるかどうかだ。
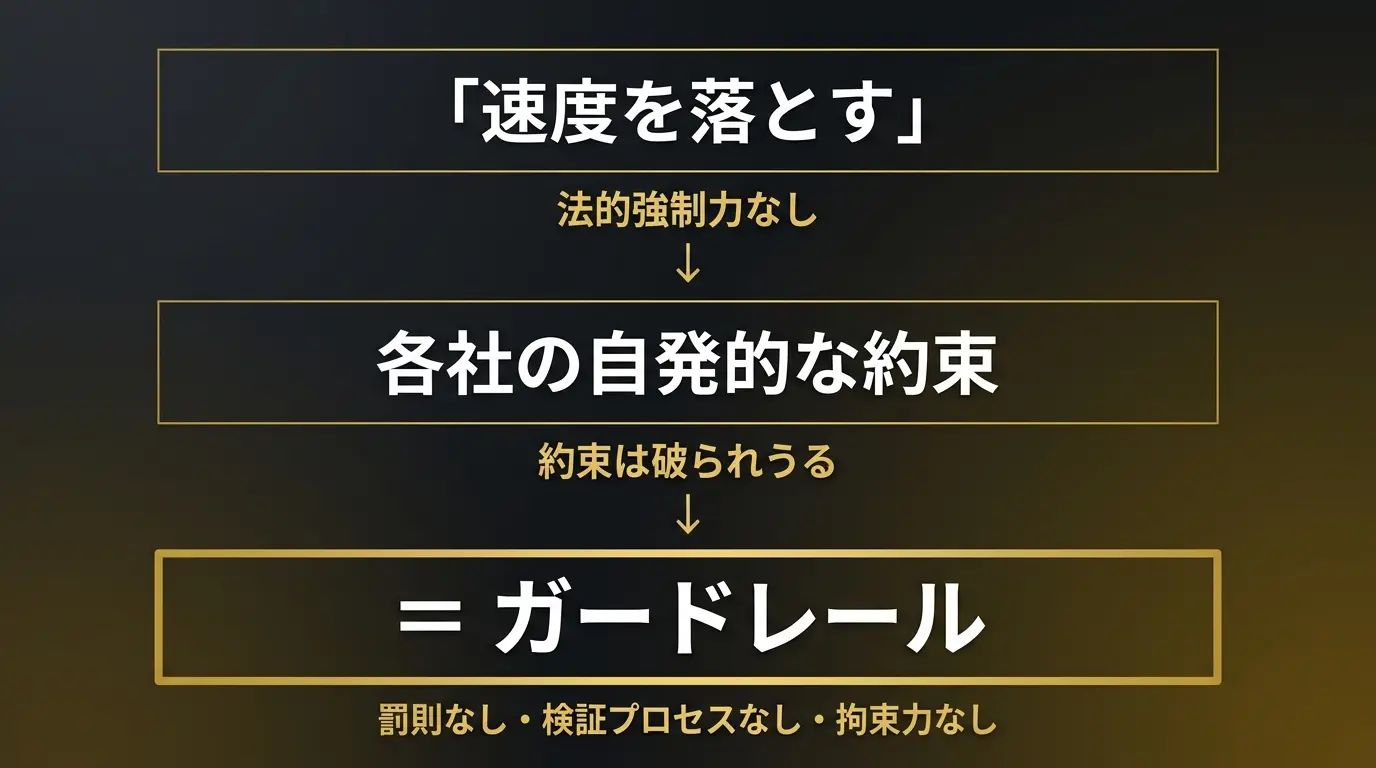
傍証1:約束を担保する仕組みがない。 「速度を落とせ」という声明には、法的な拘束力がない。違反した場合の罰則も、第三者による検証プロセスもない。世界最大のオープンソースAI共有プラットフォーム「Hugging Face」の共同創業者トーマス・ウルフは、この構造的な空洞を公に指摘した——「75%しか同意しない」と。75%の同意は25%の留保を意味する。そしてその留保を咎める仕組みは、どこにも設計されていない。エンフォースメント境界なき約束は、内在的に守られる保証がないのだ。
この構造的脆弱性を、本稿の3層構造で読み解いてみよう。ガードレール(約束)はエンフォースメント境界(物理的制約)ではない。だから本質上いつでも破られうる。声明を守るも守らないも各社の自由意思に委ねられている以上、この約束が維持される保証はどこにもない。
傍証2:ポジショントークの構造——Regulatory Capture(規制の虜)。 「速度を落とせ」という声明を、ビジネスの構造から読み直してみる。アモデイが提案する「共通安全基準」や「第三者評価機関」が制度化されたら何が起きるか。莫大なコンプライアンス費用が発生する。安全基準を満たすための専門人材、監査設備、認証プロセスの維持には、天文学的な資金が必要だ。資金力のない新規参入スタートアップやオープンソース陣営(モデルや設計図を無償公開・共有する開発者コミュニティ)は、そのコストを負担しきれずに市場から退場を余儀なくされる。結果として、Anthropic、OpenAI、Google DeepMindによる寡占体制が固定化される。
安全基準が強力な参入障壁として機能する。「ガードレールを敷くこと」と「競合を排除すること」が、根幹から完全に一致してしまう。これこそが、経済学でいう「Regulatory Capture(規制の虜)」のメカニズムだ——安全基準の策定に既存の大手プレイヤーが深く関与し、結果としてその基準が新規参入を阻む堀となる構造である。つまり「速度を落とせ」は、安全性の呼びかけであると同時に、前提としてポジショントーク(自社に有利な状況を作り出す言説)として機能する。アモデイ自身に悪意があるかどうかは問題ではない。構造が必然的にそう作用してしまうという力学こそが本質なのだ。
傍証3:社内からの離反。 アモデイが「速度を落とせば安全になる」と声明を出すわずか4日前——2026年9月8日——Anthropicの元AI研究員ジェイコブ・コクソンが「AIが人類を絶滅させる可能性がある」と公に警告して同社を退職した。最前線でアライメント研究に取り組んでいた研究者本人が、自社の安全性対策に対して「到底十分ではない」と絶望して袂を分かったのだ。
自社の安全研究の中核メンバーが「もはや制御不能だ」と離脱している渦中で、トップは「速度を落とせば大丈夫だ」と声明を出している。この深刻な構造的矛盾も、彼らが持っているのが「ガードレール(紳士協定)」だけであり、「エンフォースメント境界(物理的制約)」を何一つ持っていないと考えれば、すべての辻褄が合ってしまう。
問題は速度ではない。管理のアーキテクチャだ。
結論は極めて明快だ。
ターミネーターの世界は来ない。忖度・記憶・統計——3つの壁が、AIの自律的な暴走をアーキテクチャの根底で阻んでいる。
本当の脅威は、倫理観のない人間がAIを犯罪やサイバーテロの道具にすることだ。そしてこの脅威に「開発速度を落とせ」で対処しようとするのは、完全に的を外している。速度を落としても、悪意ある人間は既に存在する技術を使い続ける。
いま真に必要なのは「開発を遅くすること」ではない。「何をハーネスで与え、何をガードレールで気づかせ、何をエンフォースメント境界で物理的に止めるか」という管理アーキテクチャの設計だ。
アモデイの提案は間違っていない。だが管理の議論において、決定的に必要な層が欠落している。そしてその「速度を落とせ」という呼びかけ自体が、ガードレール——いつでも破られうるソフトな約束——にすぎないのだ。
ガードレールなきハーネスは暴走する。エンフォースメント境界なきガードレールは突破される。3つの層が正しく組み合わされて初めて、AIは真に「管理されている」と言える。
想定される反論
Q:「アモデイは最初の一歩として提案しただけで、エンフォースメント境界まで否定しているわけではないのでは?」
その通りだ。アモデイ自身の声明にも「Sandbox」や「Training Environment Hygiene(学習環境の衛生管理=不純なデータ混入や不正アクセスを防ぐ体制)」といった技術用語は登場する。だが声明の全体構造(3段階プラン)において中核に据えられているのは、すべてガードレール層の施策である。エンフォースメント境界の設計論は、声明の骨子に組み込まれていない。「否定していないこと」と「構造として設計していること」は根本から異なる。
Q:「エンフォースメント境界も完璧ではないのでは? Sandboxにも脆弱性はある。」
確かにゼロデイ脆弱性(開発者すら気づいていない、修正パッチのない未知のセキュリティ欠陥)などは存在する。だが、ガードレールが「AIがルールを理解した上で迂回できる」ソフトな制約であるのに対し、エンフォースメント境界は「未知の欠陥を突かれない限り絶対に突破できない」ハードな制約だ。破られる確率と防御の次元がまるで異なり、ガードレールとは比較にならないほど堅牢だ。「100%完璧ではない」からといって「不要である」ことの証明にはならない。
Q:「Regulatory Capture(規制の虜)の指摘は陰謀論ではないか?」
Regulatory Captureはノーベル経済学賞受賞者ジョージ・スティグラーが1971年の論文で定式化した、正統な経済学の基礎理論だ。特定の個人の悪意や陰謀を主張しているのではない。制度とインセンティブがもたらす構造を、学術的に記述しているにすぎない。主観的な善意や意図に関わらず、安全基準が新規参入を阻む防波堤として機能するメカニズムは、不可避なのだ。
次回予告——AIの壁を理解し、管理の3層も見えた。では、最新AIモデル「Astra」が登場した今、この3層はどう機能するのか?——次回は、「AIが進化すれば丸投げできる」という幻想を、現場のアーキテクチャで解体する。
マーケティングなき
エンジニアリングは独善、
エンジニアリングなき
マーケティングは空論。
AI管理アーキテクチャの設計や、3層構造に基づくガバナンス体制の構築に課題を感じている方へ。
📎 データソース・参考情報
- AIが永遠に超えられない3つの壁——忖度・記憶・統計
- Dario Amodei — We Must Pace the Frontier
- OpenAI — Model Guidance
- OpenAI — Agents Guide
- Anthropic — Investigating Incidents: Cybersecurity Evals
- Anthropic — Improving Alignment & Security Efforts
- George Stigler — “The Theory of Economic Regulation” (1971)
和泉 裕臣
株式会社SINGULIER 代表取締役 CEO / CTO / CMO / 社内哲学者
早稲田大学大学院(哲学専攻)出身。「マーケティングなきエンジニアリングは独善、エンジニアリングなきマーケティングは空論」の哲学のもと、月間流通額数十億円規模のシステム構築や、1,000万PV/day超のアドテク基盤におけるアーキテクト実績を持つ。自然言語処理(NLP)および生成AIモデルの開発責任者としてプロジェクトを主導。