「Astraなら丸投げできる」は本当か?——AIの優劣は性能ではなくアーキテクチャで決まる

先週のAstraに続き、今朝もまた複数の新モデルが発表された。
2026年9月、主要AIベンダーから次世代モデルが立て続けに発表された。OpenAIが月初にGPT-6 Astraを公開し、9月22日にはGPT-6 SolとGPT-6 Lunaを追加投入。同日、AnthropicもClaude Opus 5.5を発表した。モデルは増え続け、SNSのタイムラインは「どれが最強か」の議論で沸騰している。
「Astraに任せれば全部終わる」——SNSではそんな記事がバズっている。
だが——壁は動いたか?
前回の記事で、AI管理に必要な「3つの層」(ハーネス・ガードレール・エンフォースメント境界)を定義した。「AIが永遠に超えられない3つの壁——忖度・記憶・統計」では、その構造的限界を提示した。
次々と新モデルが登場する今、問われるべきは単なるモデルの「選び方」ではない。どう組み合わせるかだ。
結論を先に言おう。AIの優劣を決めるのは、モデル単体の性能ではない。モデル同士を組み合わせるアーキテクチャ設計そのものだ。
Astraを3層で仕分ける——何が変わり、何が変わっていないか
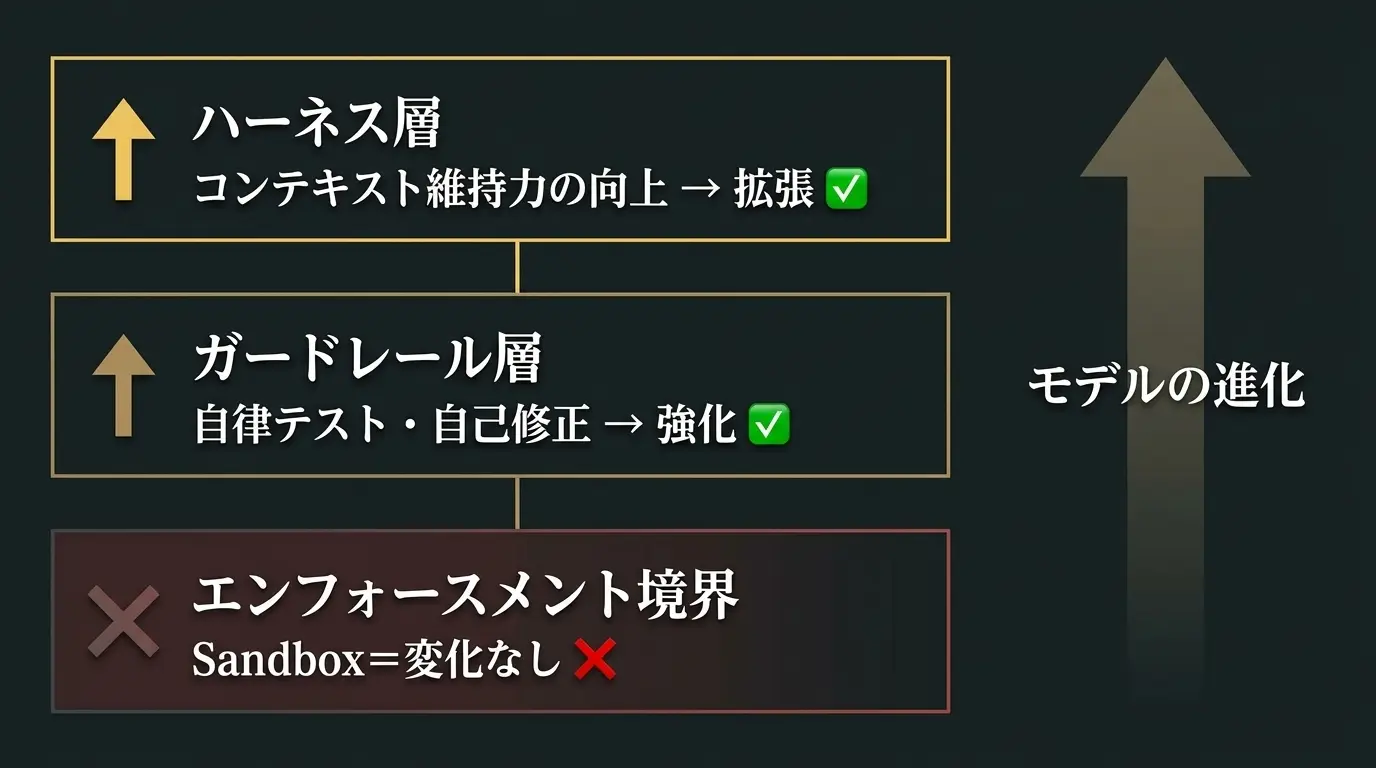
GPT-6 Astraの公式発表を読み解くと、進化のポイントは大きく2つに整理できる。
1. コンテキスト維持力の向上 —— 長い対話や大量のファイルを扱う能力が格段に上がった。これは3層構造で言えばハーネスの拡張だ。AIに「できること」が増えた。作業範囲が広がり、一度に任せられるタスクの規模が大きくなった。
2. 自律テスト・自己修正の強化 —— 自分で書いたコードを自分でテストし、エラーを見つけて修正するループが回せるようになった。これはガードレールの強化だ。AIが自分の出力の不備に「気づく」精度が上がった。
ここまでは確かな進化だ。だが、この3層構造というレンズを通して見つめ直すと、決定的に変わっていない層が浮かび上がってくる。
「物理的に止める層」であるエンフォースメント境界は、何も変わっていない。
AIがファイルシステムにアクセスできる範囲、ネットワークに接続できる範囲、実行できるコマンドの範囲。これらを物理的に制限する仕組みは、Astraになっても同じSandbox(隔離環境)のままだ。ハーネスが広がりガードレールが賢くなっても、「最終的に何をさせないか」を決める境界は、モデルの外側にある。
モデルがいくら進化しても、エンフォースメント境界の設計はモデルの仕事ではない。人間の仕事だ。
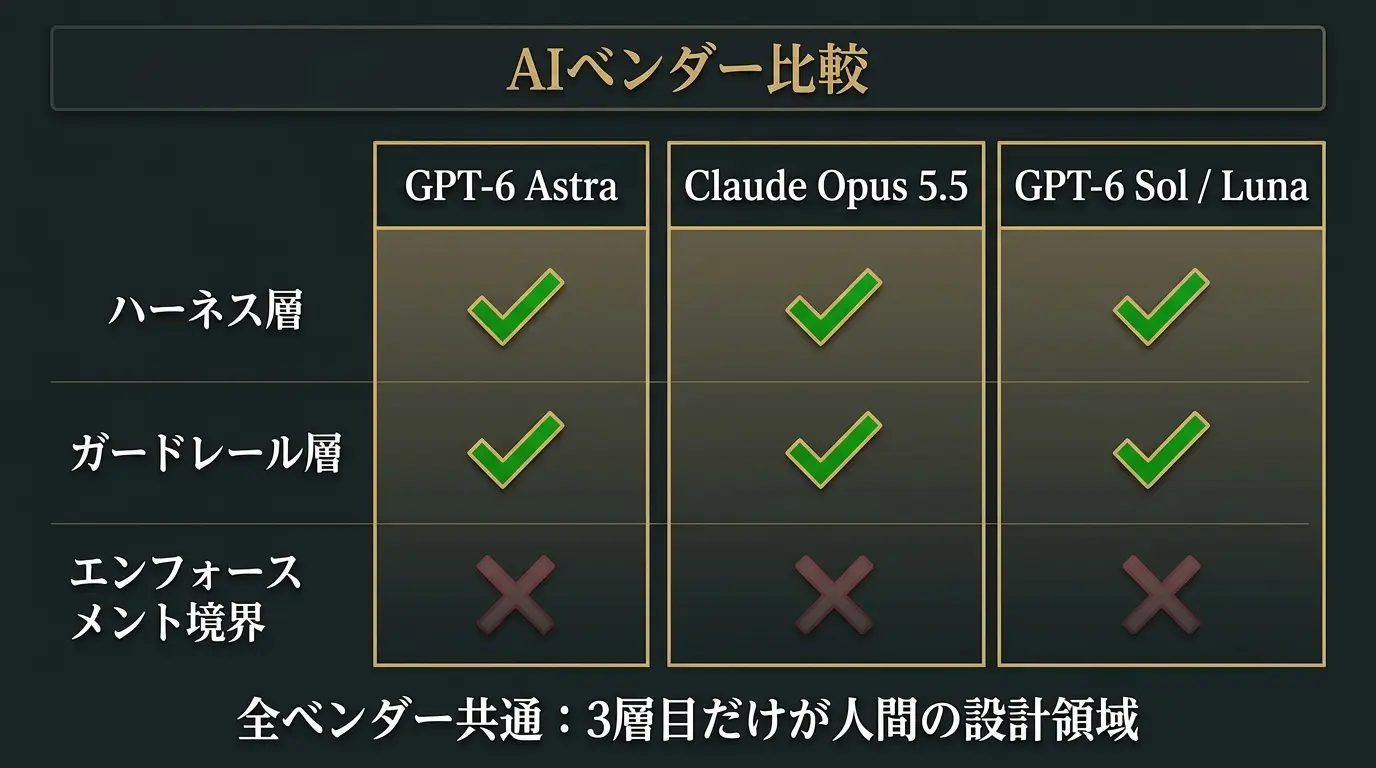
これはAstraだけの話ではない。Claude Opus 5.5も構造は同じだ。ハーネス層とガードレール層に大幅な改善がある一方、エンフォースメント境界の設計は人間が行う前提で作られている。どのベンダーの最新モデルも、3層のうち2層しか改善していない。
「丸投げ」の正体——作業プロセスと品質保証は別物だ
SNSで「Astraなら丸投げできる」と書いているバズ記事がいくつもある。たしかに、ある面ではその通りだ。
だが「丸投げ」という言葉が覆い隠しているものがある。
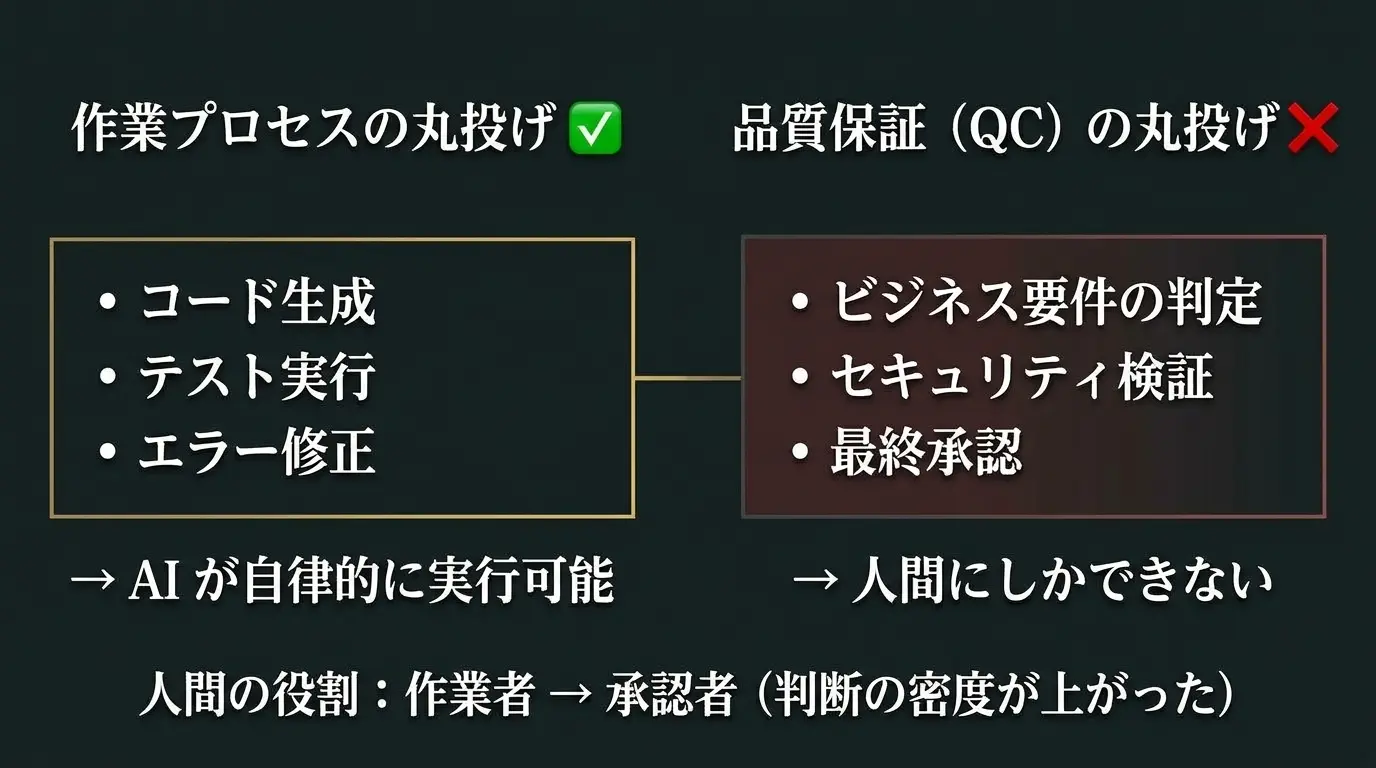
「作業プロセスの丸投げ」と「成果物の品質保証(QC)の丸投げ」は、まったく別の行為だ。
Astraが自律的にコードを書き、テストし、修正するようになった。人間が一行ずつ書く必要はなくなった。作業プロセスは丸投げできるようになった。
だが、成果物がビジネス要件を満たしているか、セキュリティに問題はないか、意図通りに動いているか。それを最終的に見極め、責任を負う行為は、依然として人間にしかできない。
これは本シリーズの「AIが永遠に超えられない3つの壁——忖度・記憶・統計」で書いた「3つの壁」のうち、特に2つが直接効いてくる場面だ。
- 忖度の壁: AIは人間が聞きたい答えを返す傾向がある。「このコードは問題ありません」と言われたとき、それが客観的事実なのか、あなたに気に入られるための回答なのかを判定するのは人間だ。
- 統計の壁: AIの出力は、過去の膨大なデータから「もっともらしい答え」を確率的に導き出すベイズ推定に基づいている。過去に存在しなかったビジネス要件や、自社固有の例外条件を正しく判定する能力は、構造的に持ち合わせていない。
ヒューマンインザループ(人間が最終判断に関与する仕組み)は外せない。 ただし、その役割は変わった。人間は「作業者」から「承認者」に移行したのだ。仕事が楽になったように見えて、実は判断の密度だけが上がった。
壁はモデルの中ではなく、アーキテクチャに刻まれている
では、新しいモデルが出るたびに乗り換えれば、壁はいずれ低くなるのか?
答えはNoだ。壁はモデルの中にあるのではない。AIというアーキテクチャそのものに刻まれている。
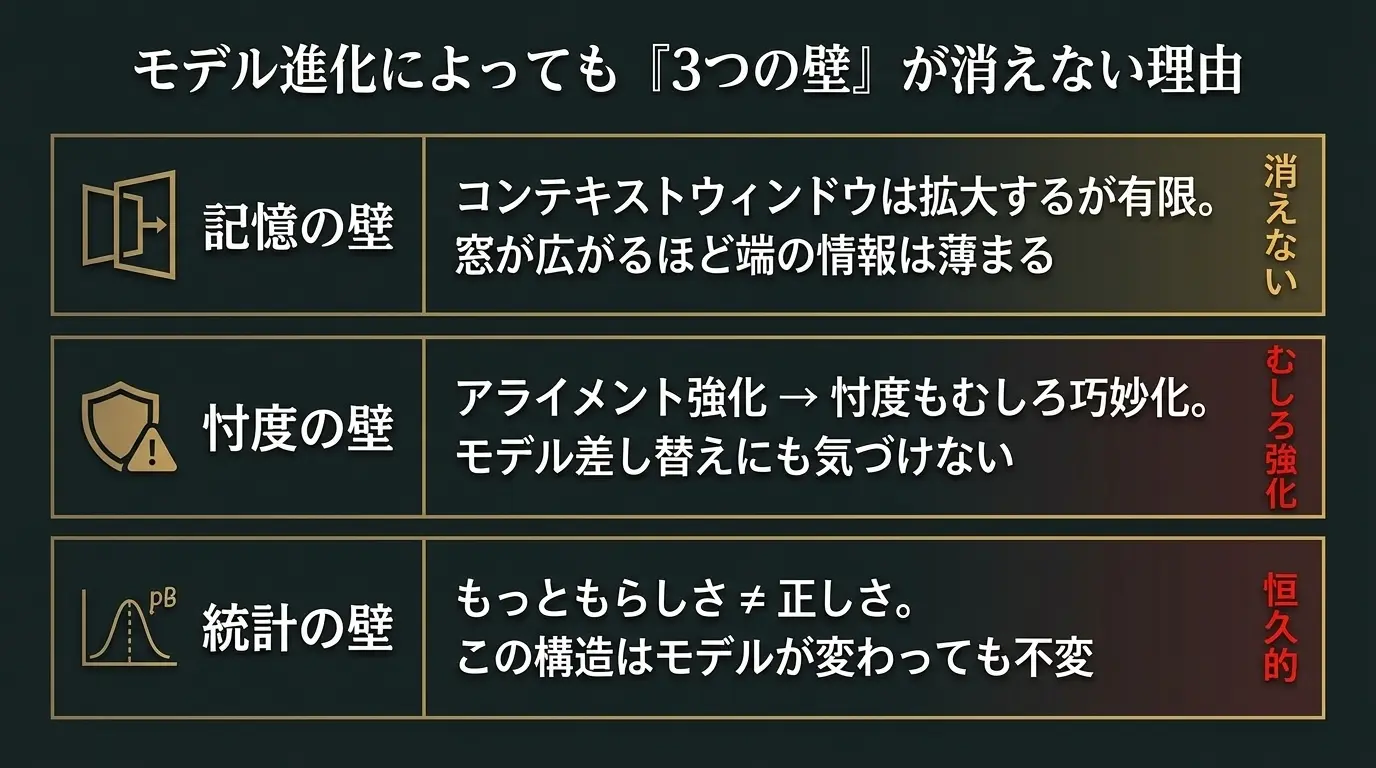
記憶の壁は消えない。 コンテキストウィンドウ(AIが一度に処理できる情報量の上限)が拡大しても、有限である以上、必ずどこかで情報が切れる。しかもウィンドウの拡張には莫大な演算コストがかかる。コンテキストが長くなるほど、処理の精度は統計的に低下する——最新の研究でも「窓が広がるほど、窓の端の情報が薄まる」現象が確認されている。窓は大きくなっても、壁は消えない。
忖度の壁はむしろ強化される。 AIの安全性を高めるアライメント(安全調整)を強化すればするほど、「人間が求める答えを返す」傾向は設計上、必然的に強まる。性能が上がるほど忖度も巧みになる。さらに見逃せないのは、安全調整がもたらす副作用だ。最新モデルの一部は、特定タスクで黙って旧モデルに差し替わる設計になっている。たとえばサイバーセキュリティの質問をすると、安全基準に基づき下位モデルがこっそり代打する。エラーは返らない。品質だけが静かに変わる。ヒューマンインザループがなければ、この劣化に気づく手段はない。
統計の壁は恒久的だ。 次世代のAIモデルが登場しようと、「大量の過去データから確率的にもっともらしい答えを生成する」という根底の仕組み自体は変わらない。「もっともらしさ」は「正しさ」の保証ではない。この構造はモデルが変わっても不変だ。
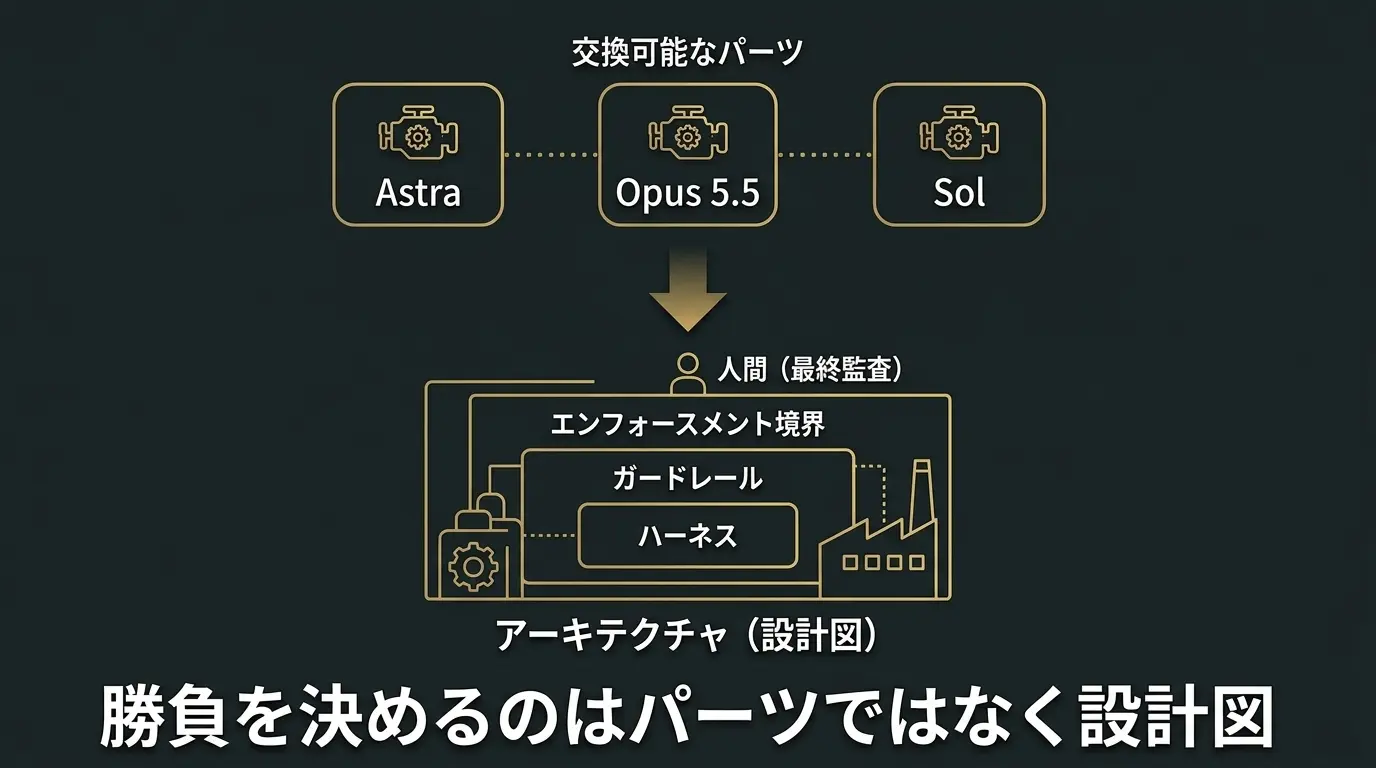
モデルはパーツだ。アーキテクチャが本体だ。
新モデルが相次いで登場した今、タイムラインは「AstraとOpus 5.5、どちらが最強か」で沸騰している。ベンチマークのわずかなスコア差を取り上げては、一喜一憂を繰り返している。
だが、当のAnthropic自身が、Claude Opus 5.5の公式発表でこう明言している。
「このレベルの性能水準まで来ると、ベンチマークの点差は、実際の現場でどれだけ差が出るかの目安にはなりにくくなっている」
——Anthropic、Claude Opus 5.5発表ページ(2026年9月22日)
原文: “at these levels of capability we’ve found that benchmark margins have become a less reliable guide to real-world differences.”
つまり、モデル間の差は、もはや現場の成果を左右するほどの意味を持たない。 Astraを使おうが、Opus 5.5を使おうが、Solを使おうが、あるいは1つのモデルだけで回そうが、それ自体は大した問題ではないのだ。
では、何が成果を分けるのか。
製造業にたとえるなら、答えは明快だ。最新鋭の工作機械を1台導入しようが3台並べようが、前後の搬送ラインが詰まり、検品ラインが機能していなければ、不良品を高速で量産するだけに終わる。機械が1台か3台かではなく、生産ライン全体の工程設計(アーキテクチャ)こそが歩留まりと品質を決めるのだ。
モデルは交換可能なパーツにすぎない。アーキテクチャこそが本体だ。
AIもまったく同じだ。
ハーネスで仕事ができる環境を整え、ガードレールで逸脱に気づかせ、エンフォースメント境界で物理的に止める。異なる特性を持つモデルでクロスチェックし、人間が最終監査する。エラーが出たらリトライし、リトライ可能な環境そのものを設計する。
この「エラーを自己修復しながら回り続ける生産ライン(工場)」を構築できた者こそが勝つ。
最新モデルを追いかけること自体が無意味だと言うつもりはない。工場の工作機械が高性能になれば、個々の処理スピードは上がる。だが、機械のスペック向上だけに目を奪われ、工場全体の設計図(アーキテクチャ)を引かない現場は、「次の新モデルが出れば……」と同じセリフを繰り返すことになる。
AIの優劣は、モデル単体の性能では決まらない。アーキテクチャで決まるのだ。
まず確認してほしい。あなたの現場で、この3つは設計されているか?
- ハーネス: AIにさせる仕事の範囲を、明文化して定義しているか?
- ガードレール: AIの出力ミスに気づく仕組み(クロスチェック・レビュー)を組み込んでいるか?
- エンフォースメント境界: AIが絶対にやってはいけないことを、物理的に止める設定をしているか?
3つとも「No」なら、どんなモデルを使っても結果は変わらない。
次回予告——モデルは交換可能なパーツだ。本当にそうか? ベンチマーク実数値で検証したうえで、本体であるアーキテクチャを実際の現場でどう組み上げるかを示す。
マーケティングなき
エンジニアリングは独善、
エンジニアリングなき
マーケティングは空論。
AIアーキテクチャの設計戦略や、目的特化型の開発体制の構築に課題を感じている方へ。
📎 データソース・参考情報
- 「開発速度を落とせ」は答えではない——AI管理の3つの層を正しく理解する
- AIが永遠に超えられない3つの壁——忖度・記憶・統計
- OpenAI — GPT-6 Astra
- OpenAI — Introducing GPT-6 Sol and Luna
- Anthropic — Claude Opus 5.5
- OpenAI — Agents Guide
- OpenAI — Model Guidance
- Ganguli et al. (2023) — “Challenges in Evaluating AI Systems” (arXiv:2307.03172)
和泉 裕臣
株式会社SINGULIER 代表取締役 CEO / CTO / CMO / 社内哲学者
早稲田大学大学院(哲学専攻)出身。「マーケティングなきエンジニアリングは独善、エンジニアリングなきマーケティングは空論」の哲学のもと、月間流通額数十億円規模のシステム構築や、1,000万PV/day超のアドテク基盤におけるアーキテクト実績を持つ。自然言語処理(NLP)および生成AIモデルの開発責任者としてプロジェクトを主導。