Opus 5.5 vs GPT-6 Astra——公式ベンチマーク比較でわかった「本当の差」と最適なAI設計戦略

1.1ポイント。
Claude Opus 5.5とGPT-6 Astraが、エージェント型コーディング(FrontierCode)のベンチマークで競い合った結果の点差だ。54.4% 対 53.3%。わずか1.1%。現場の実務において、これは完全に誤差の範囲である。
にもかかわらず、この1週間、エンジニアのタイムラインや経営会議の場では「どちらのモデルを全社導入すべきか」「どちらが真の最強か」という議論が延々と繰り返されてきた。コーディングではOpusが勝ち、業務自動化ではAstraが勝つ。互いに相手の得意領域で敗れ、相手の不得意領域で勝つ。数字をいくら凝視したところで、そこには「絶対的な勝者」など1行も記されていない。
「新モデルが出るたびに社内検証をやり直している」「どちらに全社予算を投じるべきか、判断がつかない」——もしそうした悩みを抱えているなら、立ち止まってほしい。いま多くの企業が陥っている最大の罠は、AIの性能不足ではない。「最強のモデルを選びさえすれば現場の課題が解決する」という、あまりにも素朴な信仰そのものだ。
前回の記事で、私は「AIの優劣はモデル単体の性能ではなく、組み合わせるアーキテクチャで決まる」と論じた。モデルはいつでも取り替え可能な「パーツ」に過ぎないと。あのときは構造論としての提起だった。
だが、主要ベンダーが公表した公式ベンチマークの生データを突き合わせると、それはもはや私の持論などではなく、数字が語る冷徹な「数学的事実」であることが誰の目にも明らかになる。
皮肉なことに、モデルを開発した当事者であるAnthropic自身が、公式ドキュメントで「ベンチマークの点差は現場の差の目安にならない」と白状しているのだ。
なぜ最新モデルを追いかけ続ける企業ほど、現場の成果から見放されていくのか。
本稿では、公開された公式ベンチマークの全データを検証し、モデル信仰を捨てて「外側の仕組み」に投資すべき構造的根拠を論証する。
前回の記事はこちら → 「Astraなら丸投げできる」は本当か?——AIの優劣は性能ではなくアーキテクチャで決まる
公式ベンチマークを並べると、何が見えるか
まず、直視すべき事実がある。最新モデルが全領域で最強——などという現実はどこにも存在しない。
Anthropicが2026年9月22日に公開したClaude Opus 5.5の公式ベンチマークを、GPT-6 Astraと並べる。
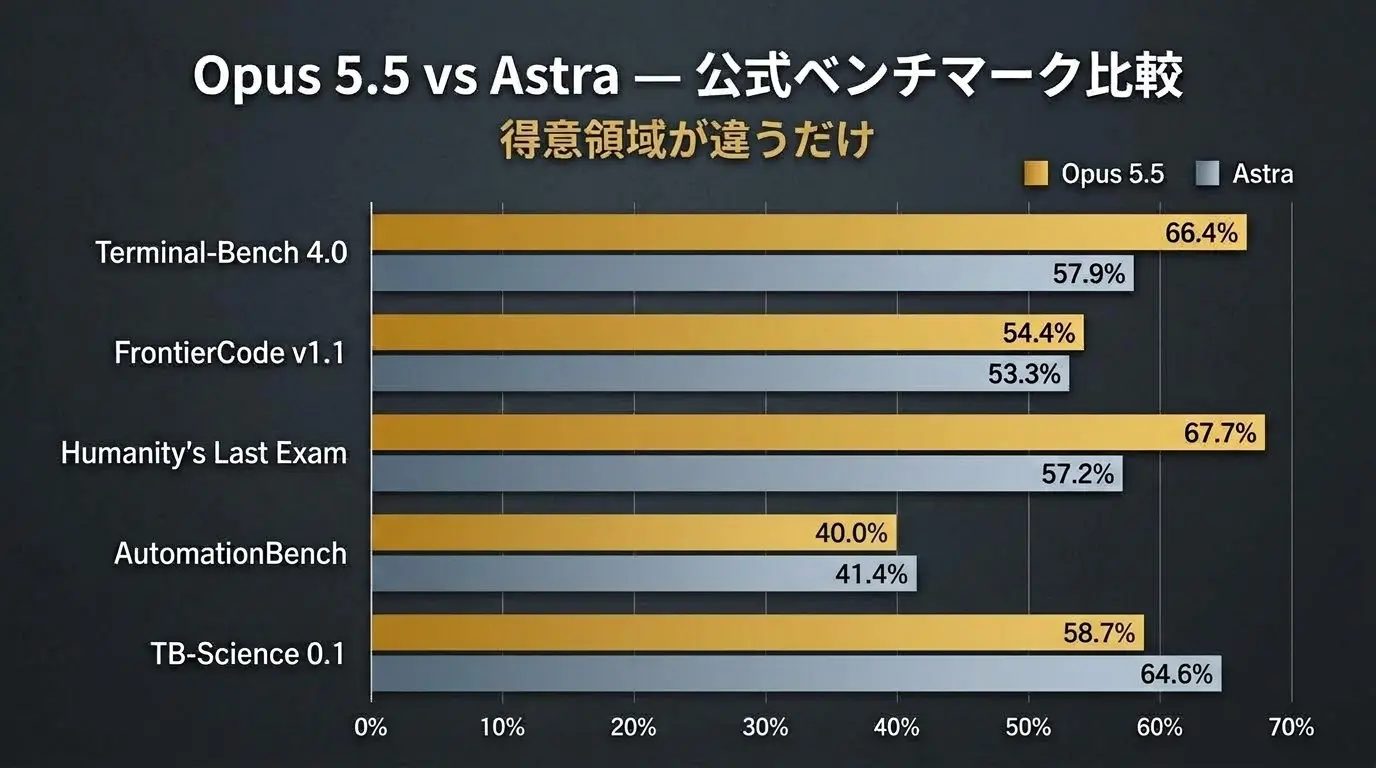
まず、5つのベンチマークがそれぞれ何を測っているかを整理する。
- Terminal-Bench 4.0 —— ターミナル操作を駆使したエージェント型コーディングの総合力。ファイル操作、Git、テスト実行まで含む実践的な開発タスクを測る。
- FrontierCode v1.1 —— 未知のコードベースに対するバグ修正・機能追加の成功率。現場のエンジニアが日常的に直面するタスクに最も近い。
- Humanity’s Last Exam —— 数学・物理学・法学など50以上の学術分野を横断する学際的推論力。「知識の深さ」と「論理の精度」の両方を試す。
- AutomationBench —— 請求書処理・データ入力・レポート作成といった業務ワークフローの自動化精度。多くの企業が最も直接的にROIを求める領域だ。
- Terminal-Bench-Science 0.1 —— 実験データの解析・論文の再現・仮説検証など、科学研究プロセスのタスク遂行力を測る。
Opus 5.5が勝つ領域:
- Terminal-Bench 4.0:Opus 5.5が66.4%、Astraが57.9%。差は8.5ポイント。
- FrontierCode v1.1:Opus 5.5が54.4%、Astraが53.3%。差はわずか1.1ポイント。
- Humanity’s Last Exam:Opus 5.5が67.7%、Astraが57.2%。差は10.5ポイント。
Astraが勝つ領域:
- AutomationBench:Astraが41.4%、Opus 5.5が40.0%。差は1.4ポイント。
- Terminal-Bench-Science 0.1:Astraが64.6%、Opus 5.5が58.7%。差は5.9ポイント。
一見するとOpus 5.5の3勝2敗に見えるだろう。だが、ここで立ち止まってほしい。あなたの現場にとって、5つのベンチマークの重みは同じだろうか?
コーディングが主力業務のソフトウェア企業であれば、Terminal-BenchとFrontierCodeの差は確かに重要だ。だが、多くの企業にとって最もROIに直結するのは「業務ワークフローの自動化」であり、そこではAstraが勝っている。科学研究機関にとっても同様に、TB-ScienceでのAstraの5.9ポイント差は無視できない。
つまり、ここに「最強モデル」など存在しない。あるのは得意領域の偏りだけだ。そしてFrontierCodeでの差に至ってはわずか1.1ポイント——現場の実務から見れば完全に誤差の範囲である。
残酷な現実を言えば、「どっちのモデルが最強か」と悩んでいる時間そのものが、すでに現場にとって最大の損失になっている。
ベンダー自身が「ベンチマークで選ぶな」と言っている
前回の記事で紹介したとおり、Anthropic自身が公式発表の中で「ベンチマークの点差は、もはや現場の差を予測する指標にはなりにくい」と明言している。自社のベンチマークを作り、測り、公表している当事者が、そう認めたのだ。
そして今回、実際にデータを並べてみた結果が、それを裏づけた。5つのベンチマークを突き合わせても、「全領域で圧倒的に勝つモデル」はどこにも存在しない。
だからといって、ベンチマークが無意味になったわけではない。上の表を見ればわかるとおり、得意領域の傾向ははっきり読める。ベンチマークは「最強を決めるトーナメント表」ではなく、「どのモデルがどの領域に強いかを把握する地図」だ。
問題は、その地図を見て「一番スコアが高いモデルを1台入れれば全部解決する」と思い込むことにある。
次々と新モデル——SNSで何が起きたか
2026年9月に入り、主要AIベンダーから次世代モデルが立て続けに発表された。OpenAIが月初にGPT-6 Astraを公開し、9月22日にはGPT-6 SolとGPT-6 Lunaを追加投入。同日、AnthropicもClaude Opus 5.5を発表した。
SNSでは3種類の記事が同時にバズった。
- 「万能論」型: 「このモデルを入れれば全部解決する」——ツールの紹介に終始する記事。
- 「完全解説」型: 新モデルの機能を網羅的に説明する記事。読者はモデルに詳しくなるが、自分の現場に何をすべきかは分からない。
- 「配属ガイド」型: 「この仕事にはこのモデルを使え」——単一ベンダー内の使い分けガイド。
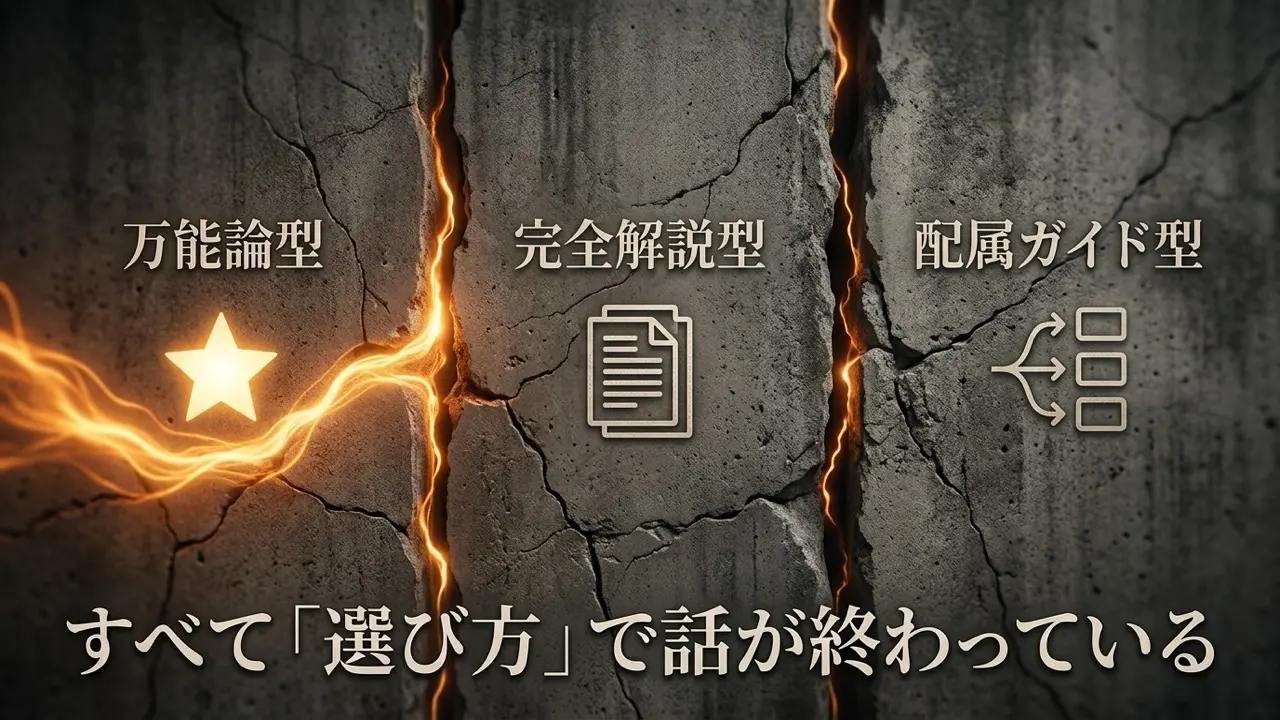
あなたも、この1週間でこの3種のうちどれかを目にしたはずだ。この3つには、ある決定的な共通点がある。議論がすべて、モデルの「選び方」で終わっている点だ。
だが、公式ベンチマークが如実に示すとおり、トップモデル同士の性能差はごくわずかであり、得意領域はきれいに分かれている。ある領域で首位のモデルが、別の領域ではあっさり逆転される。要するに、たった1つのモデルを「選ぶ」という行為そのものに、ビジネスの勝敗を分けるほどの意味はない。
ならば、得意領域ごとに使い分ければいいではないか——そう考えるかもしれない。
その着眼自体は正しい。だが、そこで問われるべきは「どのモデルをどこに配属するか」というパーツ選定の話ではない。パーツをどう組み合わせ、どう連携させるかというシステム全体の設計——すなわちアーキテクチャだ。「「開発速度を落とせ」は答えではない——AI管理の3つの層を正しく理解する」で解説した3層(ハーネス・ガードレール・エンフォースメント境界)の設計がここで効いてくる。
真に問われているのは、どのモデルを選ぶかではない。それらをどう組み上げるかだ。
「得意領域で分担」すると何が変わるか——架空のケースで考える
こんな相談があったとする——「毎月500枚の請求書処理をAIで自動化したい。AstraとOpus 5.5、どちらを導入すべきですか?」
私の答えは一言、「両方使え」だ。その理由を、ベンチマークの構造から解き明かしてみよう。
パターンA:Astra1台に全工程を丸投げする。
請求書画像を読み取って金額や日付を抜き出し、勘定科目を分類して仕訳データを生成する。Astraは業務自動化ベンチマークでトップのスコアを誇るモデルだ。一見、これ以上なく合理的な選択肢に思えるだろう。
だが、この単一モデル構成には構造的な致命傷が潜んでいる。AI自身は、自分が犯した間違いに決して気づけない点だ。 請求書の金額を1桁読み飛ばしても、勘定科目を誤って分類しても、それを自律的に検知・修正する術がない。毎月500枚という規模の現場において、サイレントなミスは確実に、雪だるま式に積み上がっていく。
パターンB:目的に合わせた専用アーキテクチャを組み上げる。
まず、請求書画像のOCR読み取りと金額・日付の抽出にはOpus 5.5を当てる。Humanity’s Last Examで10.5ポイントもの大差をつけた圧倒的な精密推論力は、「1円の誤りも許されない重要データ」の特定においてこそ真価を発揮するからだ。一方で、勘定科目の振り分けや仕訳データの生成といった定型的なワークフロー処理は、実務オペレーションを得意とするAstraの担当領域となる。
だが、単に「2台に役割を分担させた」だけでは、まだ半分だ。真に価値を生むのは、「請求書処理」という個別具体的な業務目的に特化した、リトライ可能なアーキテクチャの存在である。
- クロスチェック: Opus 5.5が抽出した金額を、Astraに「この金額と明細の整合性は取れているか」と照合させる。異種モデルの組み合わせによるガードレールだ。
- 自動リトライ: クロスチェックで不一致や矛盾が検知されたら、抽出条件やプロンプトを動的に切り替えて即座に再試行させる。1発で100点を取る必要はない。何度でも安全にやり直せるリトライ環境さえ担保されていればいい。
- 人間へのエスカレーション: 複数回のリトライを経ても整合しなかった例外的な請求書だけを、経理担当者の確認画面へとエスカレーションする。担当者が500枚すべてに目を通す必要はなく、検知された異常値だけをレビューすれば済む。
ベンチマークの数値は、現場の実運用における精度を何ら保証しない——それは開発元であるAnthropic自身が認めた事実だ。だが、確実に言えることが一つある。現場の精度を決めるのは、モデルのスペックではない。エラーに気づき、やり直し、最後に人間が止める——その工程設計があるかどうかだ。
そして、このアーキテクチャはあくまで「請求書処理」だからこそ成立する。コード生成基盤を構築するなら全く別の専用設計が求められるし、マーケティングコンテンツの制作ラインならさらに異なる制約条件が必要になる。万能の「最強モデル」が存在しないのとまったく同様に、あらゆる現場に使い回せる「最強の汎用アーキテクチャ」などどこにも存在しない。 目的ごとに、泥臭く専用のアーキテクチャを組むしかない。
ベンチマークは「最強を決める序列」ではない。自分の目的に合った専用設計の材料——それ以上でも以下でもない。
結論——ベンチマークを比べている暇に、次のモデルが出る
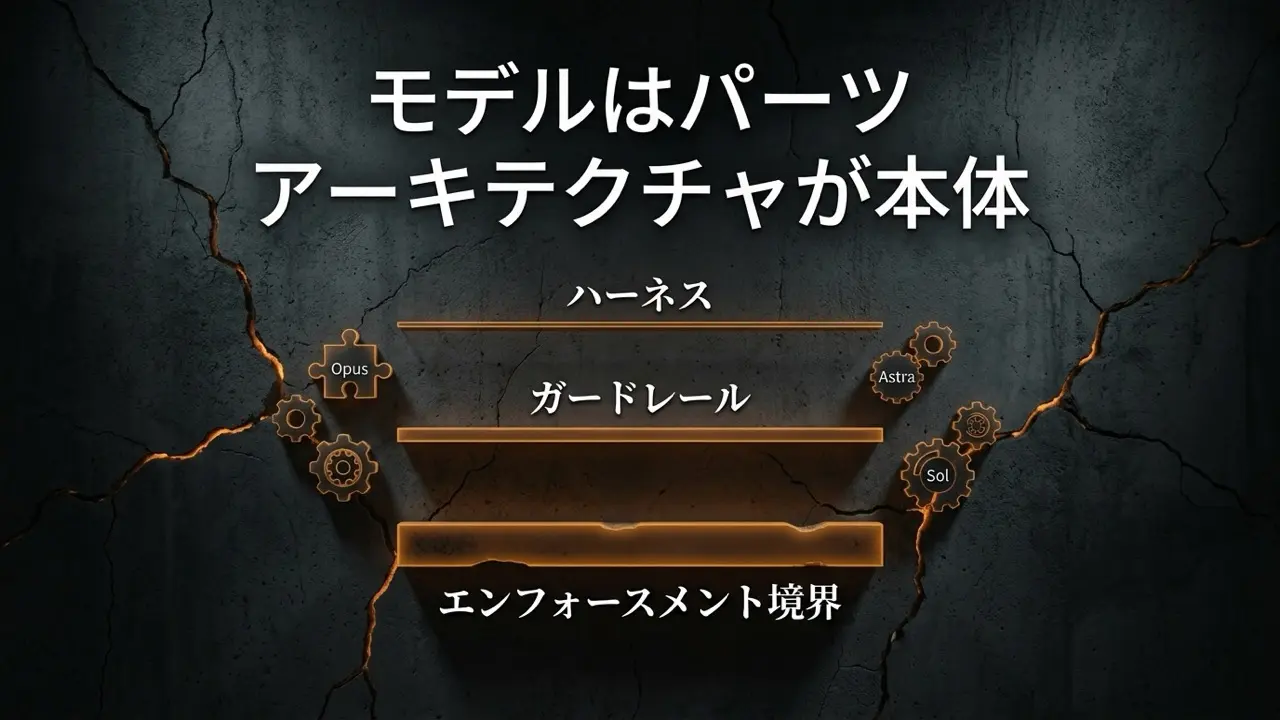
3層(ハーネス・ガードレール・エンフォースメント境界)の設計が要る——それは「AI管理の3つの層」で書いた。ここでは繰り返さない。
今回のベンチマーク比較が示したのはもっと手前の話だ。ベンチマークを「最強を決める序列」として消費するな。自分の目的に合った専用設計の材料として使え。
請求書処理のケースで見たとおり、本質はどのモデルを選ぶかにはない。異種モデルでクロスチェックさせ、エラーが出れば自動でリトライを回し、それでも解決しない例外だけを人間が止める——この工程設計が整備されているかどうかが、歩留まりのすべてを決める。
1.1ポイントの差に囚われてモデルを乗り換える暇があるなら、その工数をアーキテクチャに回せ。ベンチマーク表を睨んでいる間に、次のモデルが出る。 実際、Fable 5.1が登場したのはわずか3週間前。Opus 5.5はその3週間後だ。来月にはまた新たなモデルが世間を騒がせているはずである。
特定のモデルに自社の命運を賭けてはならない。どんなモデルが後から登場しようと、プラグインのように即座に差し替えられる「目的特化のアーキテクチャ」を、先に構築せよ。
モデルはパーツだ。ベンチマークがそれを証明した。
次回——パーツとアーキテクチャの話はここまでだ。だが、まだ1つの重要な問いが残っている——AI自身は、自分が「壁の内側」にいることに気づけるのか? GPT-6 Lunaに「3つの壁」の記事を丸ごと読ませ、反論させてみた。20分近い対話の末に起きたことを、次回報告する。
マーケティングなき
エンジニアリングは独善、
エンジニアリングなき
マーケティングは空論。
AIモデル選定戦略や、目的ごとの専用アーキテクチャの設計に課題を感じている方へ。
📎 データソース・参考情報
- 「Astraなら丸投げできる」は本当か?——AIの優劣は性能ではなくアーキテクチャで決まる
- Anthropic — Claude Opus 5.5
- OpenAI — GPT-6 Astra
- Anthropic — Claude Fable & Mythos 5.1
- OpenAI — Introducing GPT-6 Sol and Luna
和泉 裕臣
株式会社SINGULIER 代表取締役 CEO / CTO / CMO / 社内哲学者
早稲田大学大学院(哲学専攻)出身。「マーケティングなきエンジニアリングは独善、エンジニアリングなきマーケティングは空論」の哲学のもと、月間流通額数十億円規模のシステム構築や、1,000万PV/day超のアドテク基盤におけるアーキテクト実績を持つ。自然言語処理(NLP)および生成AIモデルの開発責任者としてプロジェクトを主導。