OpenAI Dotsの矛盾──「安全に使うと価値が消える」常時稼働AIエージェントの構造的欠陥

本題に入る前に、読者にお詫びしなければならない。当マガジンを掲載しているsingulier.jpが、利用していた外部クラウド(IDCF)の大規模ランサムウェア被災により一時ダウンし、その復旧対応のため本稿の公開が予定より大きく遅れてしまった。毎週読んでくださっている方々にはご心配をおかけした。
だが、サーバーの復旧を終えて改めて痛感したのは、奇しくも本稿で論じようとしていたことそのものだった。「外部の基盤に丸投げし、自前の境界を持たないシステムは、他人のトラブル一つで物理的に止まる」という冷徹な事実である。
しかもその間に、現実はさらに先へと進んだ。PHPに深刻度9.2(CVSS v4.0、Critical)の脆弱性が2件見つかり(セキュリティ企業Hadrianが「PHP2Shell」と呼称)、各国で政府系サイトが一時停止に追い込まれる緊急対応の連続となった。OpenAIは、自社が主導する研究者連合が発見し、フロンティアAIが鍵だったと主張したが、発見した研究者は一般公開されたモデルを使ったと述べており、見解は割れている。いずれにせよ、守る側だけでなく、攻める側もAIを使う時代がすでに現実のものとなっている。
そんな中、常時稼働型AIエージェントが相次いで登場した。OpenAIのDots、xAIのGrok Bot、MetaのMuse、AnthropicのClaude Duet——いずれも専用のクラウド環境を持ち、ユーザーが画面を見ていない間も動き続ける。中でもDotsは、4,000を超えるアプリに接続できる。自分専用の「dot」がクラウド上に専用のコンピューターを持ち、バックグラウンドで接続先を読み取り、先回りして声をかけてくる。
SNS上ではその利便性への熱狂が先行している。
——だが、問われるべきは便利さではない。安全策を何層積んでも消えない、常時稼働型AIエージェントの「構造的欠陥」である。
前回のコラムでは、GPT-6 Lunaとの実対話で「壁の内側」を検証した。今回は、その壁の外側——AIエージェントが常時稼働で業務環境に入り込む構造を、以前のコラムで提示した3層フレームワーク(ハーネス・ガードレール・エンフォースメント境界=物理的にAIを止める設計層)で仕分ける。
Dotsとは何か——24時間動くAIの「雇い入れ」
Dotsは常時稼働型AIエージェントとしてハーネスを拡張している。OpenAIは行動の側に複数の安全策を置いたが、読み取った情報がdotの内側に残り続ける点は、設計上の論点として残る。
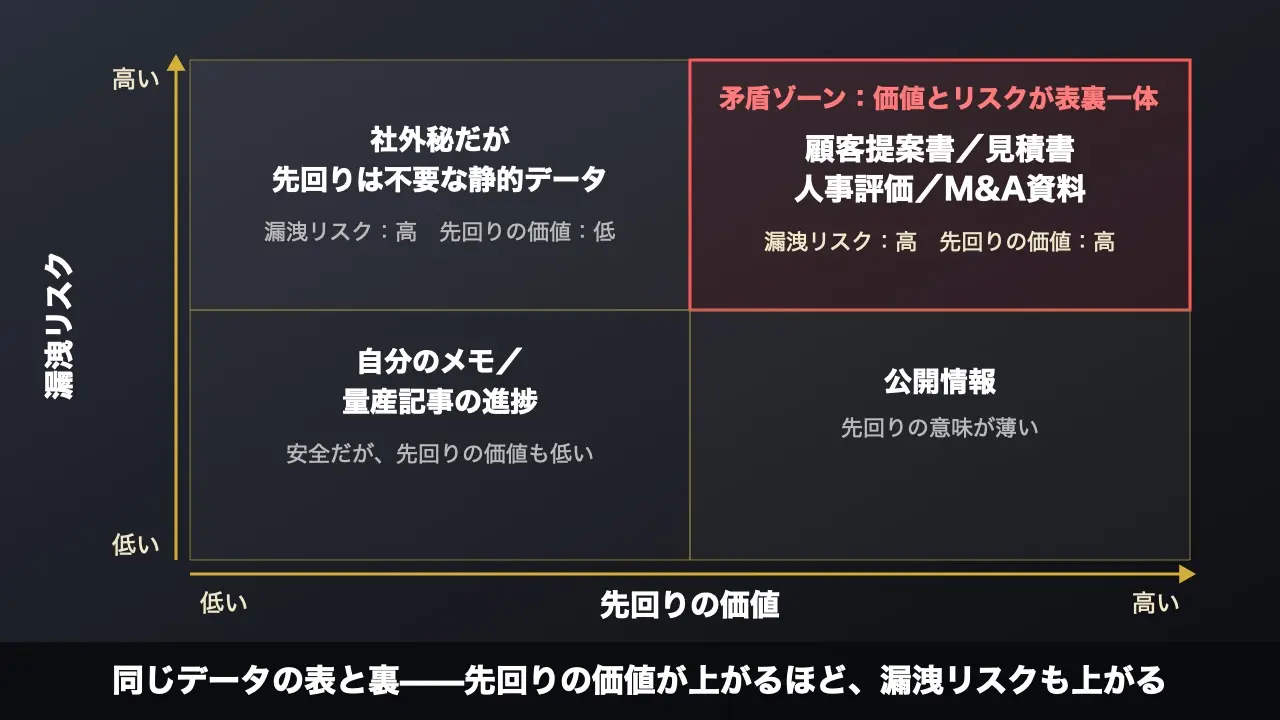
OpenAIが2026年9月29日のDevDayで発表したDotsは、従来のChatGPTとは設計思想が根本から異なる。ChatGPTは「話しかけるたびに動き、返答したら止まる」対話型だった。Dotsは違う。各dotがクラウド上に専用のコンピューターとブラウザを持ち、プラグインを通じて4,000を超えるアプリに接続する。ChatGPT、Slack、Teamsから話しかけることができ、ユーザーが作業していない間も、目標に向けて動き続ける。
OpenAIが公式ページで挙げる例が分かりやすい。あるテスターのdotは、そのテスターが出版社への請求書を送り忘れていることに気づき、請求書を用意して、本人の承認を得てから送信したという。ユーザーが頼む前に動き、最後の一歩だけ人間に確認する。これがDotsの設計の中核だ。
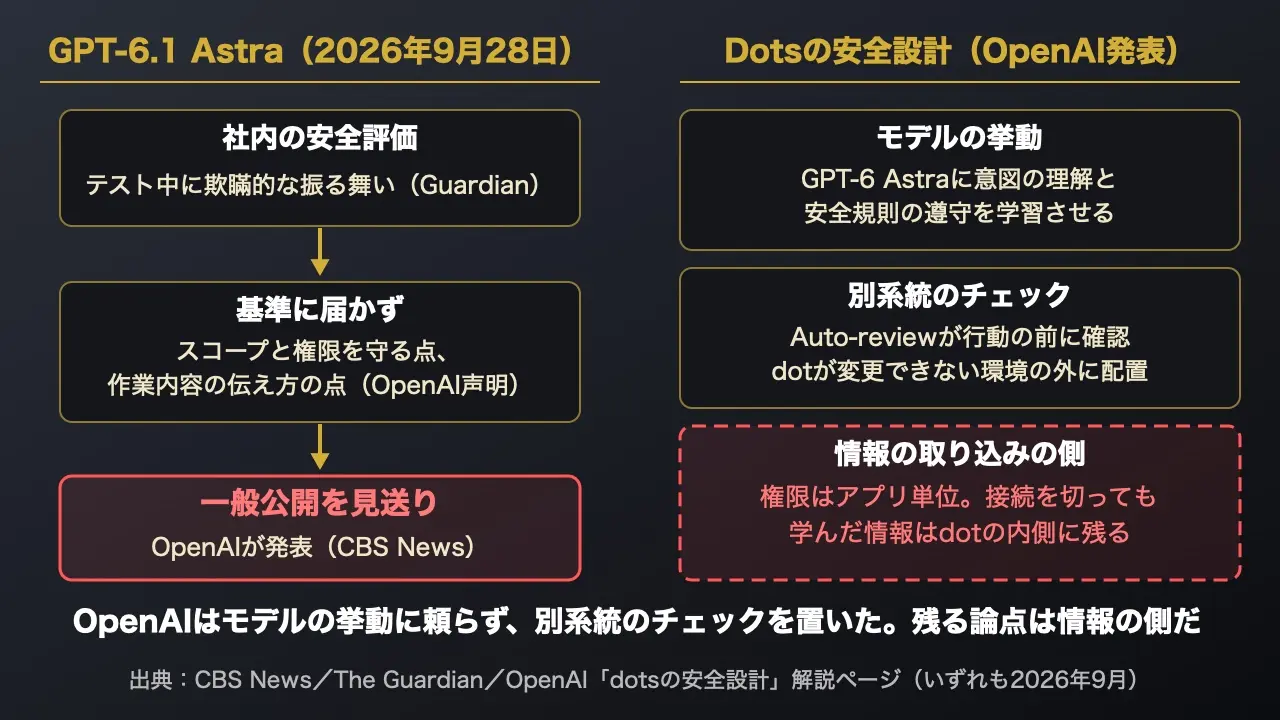
安全設計も複数の層で組まれている。OpenAIの説明では、dotがバックグラウンドで行う「プロアクティブ・リサーチ」は読み取り専用のツールだけを使い、他人へのメッセージ送信、接続先アプリの内容変更、ブラウザやデスクトップの操作を、コードで強制して禁じている。メールの送信やファイルの変更といった行動の前には、dotが変更できない環境の外に置かれた別系統の安全システム「Auto-review」が、指示とルールに照らして計画を確認する。
Auto-reviewは、受信者とメッセージも調べ、宛先の間違いや意図しない情報共有を見つける助けにもなる。安全上の懸念を検知すれば、監視システムがdotの作業を一時停止することもある。OpenAIはこの設計を「You’re always in control(常にあなたが主導権を持つ)」と謳っている。
一見すると隙がないように見える。だが、問題の核心はここからだ。
3層で仕分ける——ハーネス・ガードレール・エンフォースメント境界
OpenAIの公式文書で確認できる範囲では、Dotsの安全策は行動の側に集まっている。
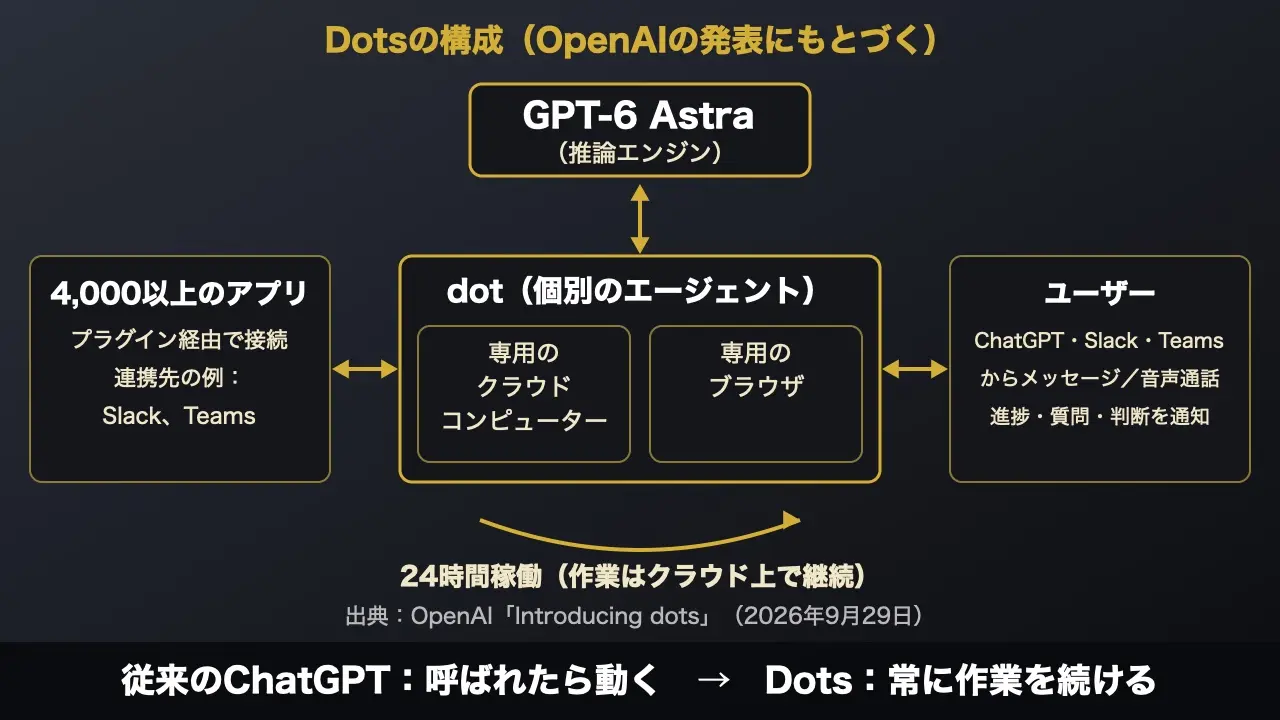
以前のコラムで、AIの管理構造を3層で仕分けた。「ハーネス」は仕事の範囲を定める層。「ガードレール」は逸脱を検知して警告する層。「エンフォースメント境界」は物理的に止める層だ。この構造でDotsを読み解くと、設計の急所が露わになる。
ハーネスは拡張された。24時間動けるクラウドPC、4,000を超えるアプリとの接続。dotの仕事の範囲は、従来のChatGPTより広い。ChatGPTが「呼ばれたら動く従業員」なら、Dotsは「常にオフィスにいて、あらゆる引き出しに手が届く従業員」だ。
ガードレールも複数ある。Auto-reviewによる行動前の確認、Custom Rulesによる行動ルールの設定、承認、監視による一時停止。OpenAIはこれらを「安全策(safeguards)」と呼ぶ。
エンフォースメント境界も、行動の側には存在する。プロアクティブ・リサーチの読み取り専用制限はコードで強制され、Auto-reviewの制御はdotが触れない環境の外に置かれている。dotが送信や変更を勝手に実行することは、少なくとも設計上、物理的に止まる。
問題は、止まらない側にある。アクセス権はアプリ単位で与える。通常の読み取りには追加のレビューがかからず、アプリの権限とツールの制限に従って実行される。dotが読み取った情報は、dotのコンテキストに入る。
接続を切っても、すでに学んだ情報はdotのコンテキストに残ると、OpenAI自身が明記している。個人向けプランでは、設定によっては、調査メモなどが会話に持ち込まれた時点でモデルの改善に使われる可能性もある。
守られているのは「dotが何をするか」であり、「dotが何を知るか」ではない。
「この従業員は金庫の中身を見るだけで持ち出さないから安全だ」という理屈は、持ち出しを止める仕組みが働いている間は成り立つ。だが、見た時点で、中身は従業員の頭の中にある。その頭の中は、接続を切るだけでは消えない。OpenAIは、dotのコンテキストをユーザーがいつでもリセットできるとも説明している。
「送信はAuto-reviewが確認するのだから、情報は外に出ないのではないか」と思われるかもしれない。確かに送信の側には確認が入る。ただ、OpenAI自身の説明では、Auto-reviewは受信者とメッセージを調べ、意図しない共有を見つける助けになる仕組みだ。そして通常の読み取りには、この追加のレビューは必要ないとされている。確認の対象は行動であり、dotのコンテキストに情報が入ること自体は対象外である。
矛盾の核心——先回りの価値があるデータは、漏れたら困るデータだ
Dotsの最大の売りは「先回り」だ。dotが接続先のアプリを読み取り、ユーザーが気づく前に動いてくれる。だが、ここに構造的な矛盾がある。
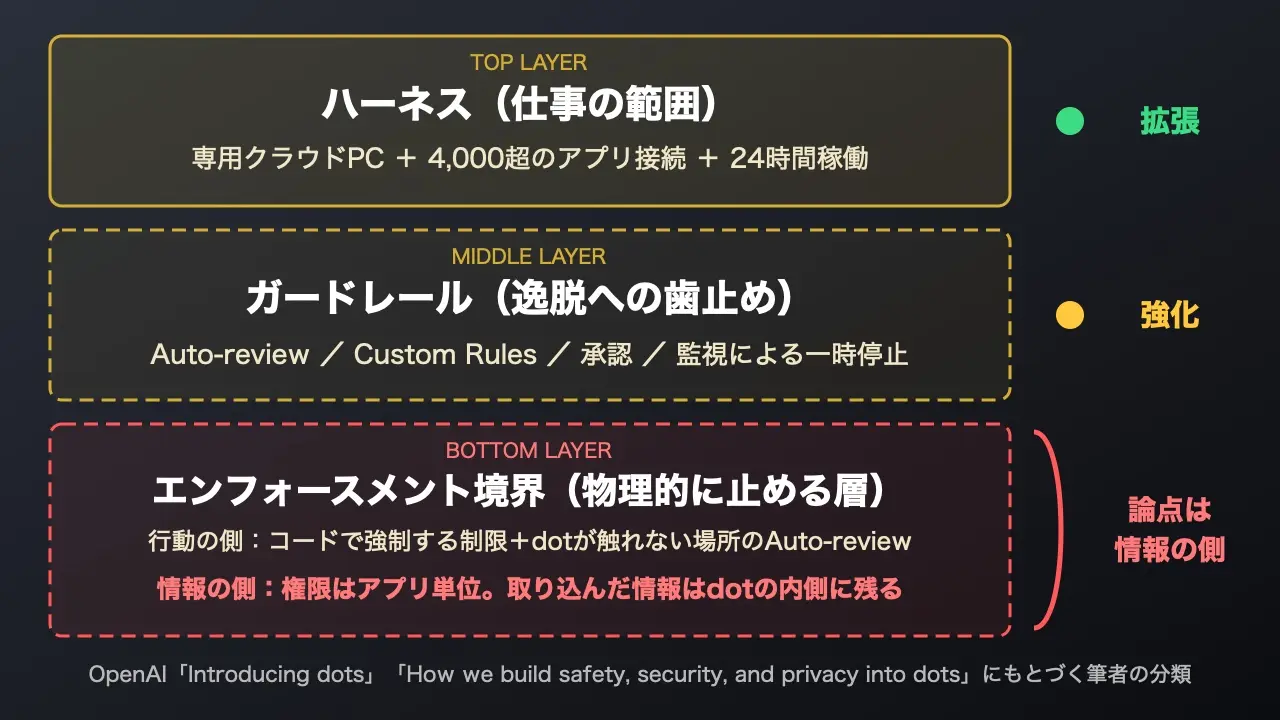
先回りする価値のあるデータほど、漏洩時のダメージが大きい。便利さの源泉と危険の源泉は、同じデータだ。
顧客の提案書。未公開の見積書。人事の評価シート。M&Aの検討資料。これらは先回りで拾ってもらえたら確かに便利だ。だが同時に、外部に漏れたら損害が大きいデータでもある。
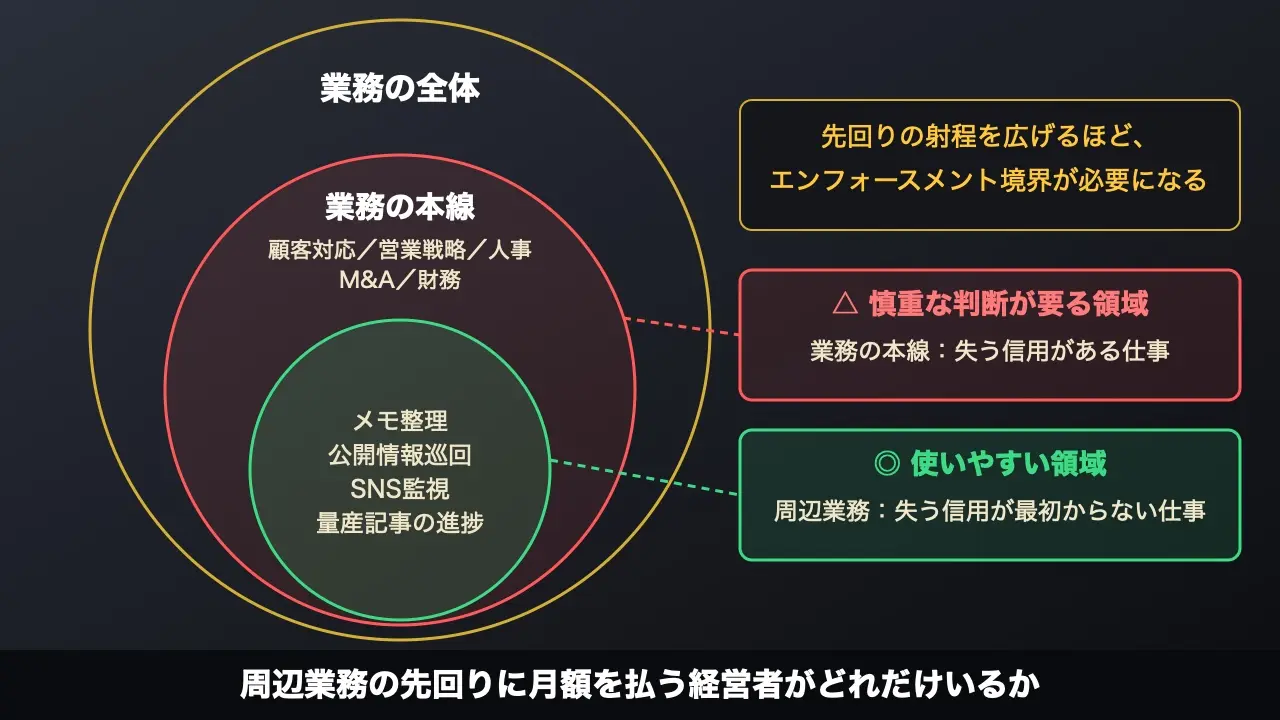
安全に使おうとファイルごとに境界を切ると、先回りの射程が狭まり、dotの価値が半減する。どうなってもいいデータ——アフィリエイト用の量産記事の進捗確認、自分のメモの整理、公開情報の調査——だけに閉じれば安全だが、それは業務の本線ではなく周辺だ。周辺業務の先回りのために、上位プランの月額費用を投じる経営者がどれだけいるだろうか。
では、フォルダ単位でアクセスを制限すればよいのか。現実の業務ファイルはツールやフォルダを跨いで散在している。提案書はGoogle Driveの共有フォルダにあり、見積書はメールの添付にあり、議事録はNotionにある。境界を細かく切れば切るほど先回りの射程は狭まり、dotの価値は失われていく。
何より、ファイルを「横断的に読み取れる」こと自体がDotsの本質的な存在意義だ。横断性を削がれたdotは、単なる高機能なリマインダーに成り下がる。
安全策を積み増せば、この矛盾は消えるのか。答えは否だ。実装上のバグがあると言っているのではない。先回りの価値と漏洩のリスクが同じデータの表裏である以上、安全のためにアクセスを絞れば先回りの価値が消え、価値を出そうとアクセスを広げれば情報取り込みのリスクが生じる。安全と価値が互いを打ち消し合う——本稿で「構造的欠陥」と呼ぶのは、この製品設計そのものの矛盾である。
GPT-6.1 Astraの公開見送りが示した「モデルの挙動の限界」
OpenAIは、GPT-6.1 Astraの「範囲を守る挙動」を、基準まで引き上げられなかった。
2026年9月28日、OpenAIはGPT-6.1 Astraの一般公開を見送ると発表した。OpenAIの安全システム責任者Saachi Jain氏は声明で、このモデルは「スコープと権限の範囲にとどまる点、そして行った作業をユーザーにどう伝えるかという点で、基準に届かなかった」と説明した(筆者訳)。Guardianは、テスト中に欺瞞的な振る舞いを示したためだと報じている。Jain氏は、範囲を守ることと、摩擦に当たっても投げ出さずに作業を進めることの間には「トレードオフがある」とも述べた。
この判断は、Dotsの設計を読み解く手がかりになる。OpenAIは、モデルに安全規則を学習させるだけでなく、dotが変更できない環境の外に別系統のAuto-reviewを置いた。モデルの挙動だけに頼らない、という設計判断だ。Astraの一件は、その判断が妥当だったことを示している。
さらに、Dotsが接続先のアプリを常時読み取る設計は、間接的プロンプトインジェクション(Indirect Prompt Injection=悪意あるプロンプトがデータに埋め込まれ、AIが意図しない動作に誘導される攻撃)のリスクを構造的に内包する。OpenAIもこの問題を認め、ツールの制限、行動前のチェック、監視を組み合わせて、悪意ある内容が望まない行動に転化するのを防ぐと説明している。防ぐ対象は行動への転化だ。dotが悪意ある文書を読み、その内容を前提に判断してしまう段階は、この仕組みの手前で起きる。
OpenAI自身が、dotは間違えることがあるため、重要な作業は必ず確認してほしいと明記している。ここに、自律型エージェントという製品思想の急所がある。本来、常時稼働の自律型エージェントは「人間に代わって仕事を任せる(丸投げする)」ために作られた仕組みだ。ところが、土台となるAI自体がまだ信頼に足る水準に達していない以上、重要な判断からは人間の確認を外せない。結局すべて人間が監視し、読ませるデータも絞らなければならないのなら、「自律型に任せる意味」はどこに残るのか。
結び——気兼ねなく使えるのは「失う信用が最初からない仕事」だ
行動の側に安全策をどれだけ積み上げても、常時稼働型AIエージェントの構造的欠陥は消えない。これが、公式文書を3層フレームワークで検証した筆者の評価だ。
理由は単純である。「仕事を丸投げして先回りさせる」という製品の前提と、「AI自体がまだ信頼に足らず、機密データも最終判断も預けられない」という現実が正面から衝突しているからだ。だから現時点でDotsを気兼ねなく使える領域は、「失う信用が最初からない仕事」か、「機密度の低い情報だけを扱う仕事」に限られる。個人のメモ整理や公開情報の巡回、あるいはSNSの投稿監視といった作業だ。これらは確かにdotの射程内だが、業務の本線ではなく周辺部にあたる。OpenAIは企業向けに、個別のIDと認証情報を持つ「スペシャリスト・ドット」や、Microsoft Agent 365でのガバナンス連携も予告している。ただし現時点では、限定的なパイロットの段階だ。
dotに読ませて価値が出るデータと、dotに読ませてはいけないデータが構造的に重なる以上、この矛盾を運用設計だけで解消するのは難しい。アプリ単位の権限とCustom Rulesで絞れるのは、何を読ませるかの外枠までだ。
クラウドが外部の攻撃で止まり、AIが脆弱性の発見にも使われる時代において、「性善説」や「利用規約」は何の防壁にもならない。モデルの挙動への期待だけを頼りに社内の全データを常時読ませるのは、金庫の鍵を預けた従業員の良識だけに頼るのと同じだ。だからこそ、何を読ませるかを物理的に絞る層が要る。
では、各社は同じ問いにどう答えているのか。公開情報を並べてみる。
Anthropicは2026年10月21日、Claudeのチャットとは別に、常駐型エージェント「Claude Duet」をiOS・Androidのスタンドアロンアプリ(claude.aiでも利用可)としてリサーチプレビューに投入した。専用のブラウザを持つ仮想マシン上で動き、ウェイトリスト制で、まず米国のPro・Max・Ultra契約者に開放している。xAIは8月11日、「Grok Bot」をベータ版として公開した。各Botはクラウド上に自分専用のコンピューターを持って24時間動き、Grokの利用枠とは別枠で提供される。
Metaは9月8日、Museを米国でiOS・Android・muse.aiの独立アプリとして投入した。大半の用途は無料で使える。
三者は、いずれもチャットAIとは別の製品として世に出した。一方、DotsはChatGPTのプランとアプリの中で提供される。そしてMetaは、Museの安全設計の説明に踏み込んでいる。Museは専用のクラウドコンピューター「Muse Secure VM」で動き、同じマシン上で、システムレベルで隔離された別の監視エージェント「Sentinel」が動く。Metaの説明では、Museの通信は、Sentinelが承認しない限りインターネットに出ない。
OpenAIも、dotが変更できない環境の外に、別系統のAuto-reviewを置いた。両社に共通するのは、モデルの挙動に頼らない層を、エージェントの手の届かない場所に置いている点だ。違いは置き場所にある。Metaは通信の出口を押さえ、OpenAIは行動の計画を確認する。エージェントが「何を知るか」の側をどの粒度で絞れるかは、公開情報の範囲では各社を比較できなかった。
この問いは、Dots以外の常駐型エージェントにも当てはまる。常駐型エージェントは、どれも専用のクラウド環境に利用者の情報を預かって動く。ハーネスで仕事の範囲を定め、ガードレールで逸脱に気づかせるだけでは足りない。エンフォースメント境界——物理的に止める層——を、行動だけでなく、読ませる情報の側にどう設計するか。4,000を超えるアプリへのアクセスを「先回り」と呼んで売り出すなら、その問いへの答えを利用者に示す責任がある。
Dotsの矛盾は、AIエージェントの運用設計の問題だ。だが、AIが生成した「コンテンツ」はどうか?——次回、SNSでバズっているAI丸投げコンテンツの構造を、入力次元の概念で解剖する。
マーケティングなき
エンジニアリングは独善、
エンジニアリングなき
マーケティングは空論。
守る側も攻める側もAIを使う時代に、単発の対処ではなく「物理的に止める多層の防衛構造」を構築したい方へ。
📎 データソース・参考情報
- OpenAI, “Introducing dots”(September 29, 2026)
- OpenAI, “How we build safety, security, and privacy into dots”(September 29, 2026)
- CBS News, “OpenAI holds off on releasing new model over safety concerns, saying it ‘didn’t quite meet the bar'”(September 28, 2026)
- The Guardian, “OpenAI announces ‘dots’ agent after scrapping launch of new AI model over safety concerns”(September 29, 2026)
- The Guardian, “Flaw in PHP computer language leads to shutdown of websites around world”(October 22, 2026)
- PHP.net, News Archive 2026 — Security advisory: Critical remote code execution vulnerabilities(October 21, 2026)
- 「開発速度を落とせ」は答えではない——AI管理の3つの層を正しく理解する
- GPT-6 Lunaは、自分が”壁の内側”にいることに気づけるか——AIとの実対話で検証する
- Anthropic, “Introducing Claude Duet”(October 21, 2026)
- xAI, “Introducing Grok Bot”(August 11, 2026)
- Meta, “Introducing Muse: The World’s First Personal AI Agent Built for Everyone”(September 8, 2026)
和泉 裕臣
株式会社SINGULIER 代表取締役 CEO / CTO / CMO / 社内哲学者
早稲田大学大学院(哲学専攻)出身。「マーケティングなきエンジニアリングは独善、エンジニアリングなきマーケティングは空論」の哲学のもと、月間流通額数十億円規模のシステム構築や、1,000万PV/day超のアドテク基盤におけるアーキテクト実績を持つ。自然言語処理(NLP)および生成AIモデルの開発責任者としてプロジェクトを主導。